Indice / Visualizacion con Matplotlib / 8.3
Líneas: tendencia en el tiempo
La línea es el gráfico que más afirma y el que más fácil se equivoca, porque une puntos que quizás no están en el orden que vos creés y salta huecos que quizás no viste.
Para qué sirve
La pregunta es «¿cómo cambia esto con el tiempo?» y la respuesta que interesa casi nunca es un valor: es una forma. Sube, baja, oscila, se aplana, tiene un salto en una fecha concreta. Eso se ve en un segundo en una línea y no se ve nunca en una tabla de noventa filas.
El precio es que la línea hace dos promesas fuertes sin avisar: que el eje horizontal está ordenado y que entre dos puntos no falta nada. Las dos se rompen con datos reales, y ninguna de las dos roturas produce un error.
ELI5Explicado facil
Una línea es como el recorrido de una excursión dibujado en un mapa.
- Si numerás mal las paradas, el recorrido va y vuelve como loco aunque las paradas estén todas en el lugar correcto.
- Si un día no anotaste dónde estuviste, el mapa dibuja una recta desde el día anterior al siguiente, como si hubieras ido derecho. Y no hay nada en el dibujo que diga que ese tramo es inventado.
El ejemplo mínimo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

consumo = pd.DataFrame({
    "dia": range(1, 21),
    "kwh": [210, 218, 215, 225, 232, 228, 240, 247, 243, 252,
            260, 258, 269, 275, 271, 282, 289, 286, 295, 304]})

# mode="valid" devuelve 17 valores, no 20: el promedio de cuatro dias no
# existe hasta el cuarto dia. Hay que alinearlo a mano, y esa incomodidad es
# preferible a que la linea diga que el dia 1 tiene una media de cuatro dias.
movil = np.convolve(consumo["kwh"], np.ones(4) / 4, mode="valid")
dias_movil = consumo["dia"].iloc[3:]

fig, ax = plt.subplots()
ax.plot(consumo["dia"], consumo["kwh"], color="0.6", marker="o",
        markersize=4, label="Consumo diario")
ax.plot(dias_movil, movil, color="crimson", linewidth=3,
        label="Media movil de 4 dias")
ax.set_title("Consumo del edificio y su tendencia")
ax.set_xlabel("Dia")
ax.set_ylabel("kWh")
ax.set_xticks(range(1, 21, 2))
ax.legend()
fig.tight_layout()
plt.show()

print("puntos de la serie:", len(consumo), " de la media movil:", len(movil))
print()
print(pd.DataFrame({"dia": dias_movil.to_numpy(),
                    "kwh": consumo["kwh"].iloc[3:].to_numpy(),
                    "movil": movil.round(2)}).to_string(index=False))
print()
print("La serie sube y baja todos los dias; la media movil solo sube.")
print("El suavizado no agrega datos: saca ruido para que la tendencia se vea.")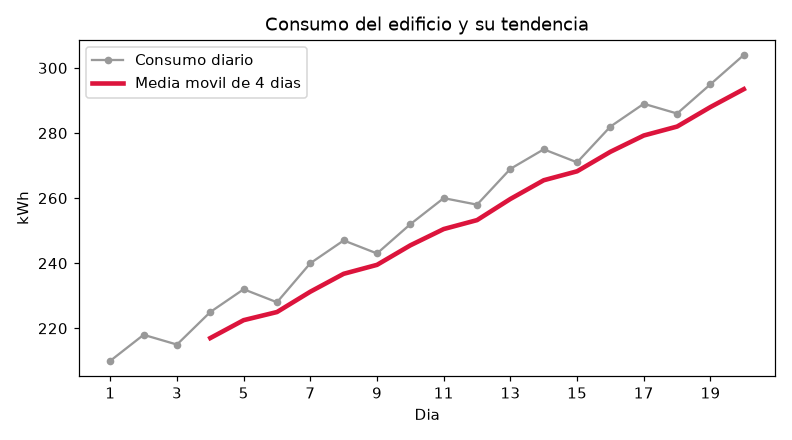
puntos de la serie: 20  de la media movil: 17

 dia  kwh  movil
   4  225 217.00
   5  232 222.50
   6  228 225.00
   7  240 231.25
   8  247 236.75
   9  243 239.50
  10  252 245.50
  11  260 250.50
  12  258 253.25
  13  269 259.75
  14  275 265.50
  15  271 268.25
  16  282 274.25
  17  289 279.25
  18  286 282.00
  19  295 288.00
  20  304 293.50

La serie sube y baja todos los dias; la media movil solo sube.
El suavizado no agrega datos: saca ruido para que la tendencia se vea.np.convolve(..., mode="valid") con ventana 4 sobre 20 días devuelve
17 valores: el promedio de cuatro días no existe hasta el cuarto día. Hay que alinear
a mano con dias.iloc[3:].
El atajo tentador es mode="same", que devuelve 20 y evita el trabajo.
Lo que hace es rellenar los bordes con ventanas incompletas, así que los primeros
valores están calculados con menos días de los que dicen y la curva queda corrida
respecto de la serie. Es un error que nadie ve y que corre la tendencia justo donde
suele estar la conclusión.
Sobre datos de verdad
Lo que pasa si graficás la columna tal como viene
import pandas as pd
import matplotlib.pyplot as plt

ventas = pd.read_csv("ventas_mensuales.csv")
ventas["total"] = ventas["unidades"] * ventas["precio_unitario"]

# Las primeras 30 filas, tal como vienen en el archivo. La columna fecha es
# texto y el archivo no esta ordenado por fecha.
primeras = ventas.head(30)

fig, ax = plt.subplots()
ax.plot(primeras["fecha"], primeras["total"], marker="o", markersize=4)
ax.set_title("Ventas por fecha, en el orden del archivo")
ax.set_xlabel("Fecha")
ax.set_ylabel("Importe")
ax.tick_params(axis="x", labelrotation=90, labelsize=6)
fig.tight_layout()
plt.show()

print("primeras diez fechas del archivo:")
print(primeras["fecha"].head(10).to_list())
print()
print("La columna fecha es de tipo:", ventas["fecha"].dtype)
print()
print("Dos cosas rotas de una vez:")
print("  1. matplotlib trata cada fecha como una categoria y las pone en el")
print("     orden en que aparecen, asi que la linea va de marzo a febrero.")
print("  2. cada fila es una venta, no un dia: hay fechas repetidas y")
print("     el grafico dibuja una posicion distinta para cada una.")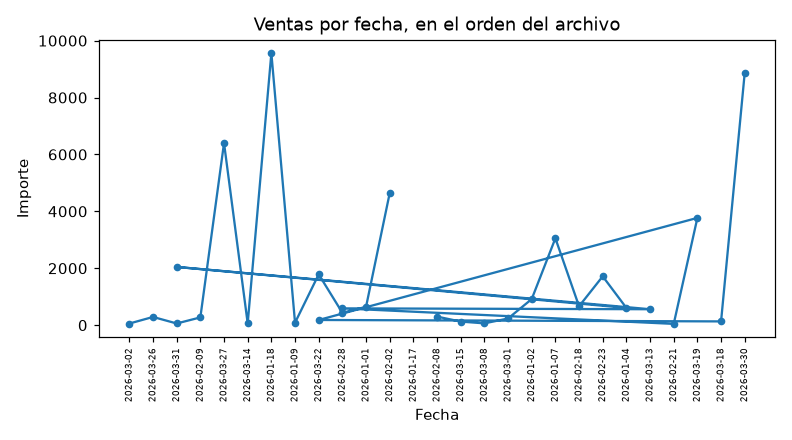
primeras diez fechas del archivo:
['2026-03-02', '2026-03-26', '2026-03-31', '2026-02-09', '2026-03-27', '2026-03-14', '2026-01-18', '2026-01-09', '2026-03-22', '2026-02-28']

La columna fecha es de tipo: str

Dos cosas rotas de una vez:
  1. matplotlib trata cada fecha como una categoria y las pone en el
     orden en que aparecen, asi que la linea va de marzo a febrero.
  2. cada fila es una venta, no un dia: hay fechas repetidas y
     el grafico dibuja una posicion distinta para cada una.
La línea vuelve para atrás varias veces. No es un error de Matplotlib: hizo
exactamente lo que se le pidió. La columna fecha es texto,
así que cada valor distinto es una categoría, y las categorías se ubican en el orden
en que aparecen en los datos. El archivo no está ordenado por fecha, y encima hay
fechas repetidas, porque cada fila es una venta y no un día.
Son dos problemas y hay que resolver los dos: el tipo de la columna y el grano de la tabla.
Convertir, agrupar y recién ahí dibujar
import pandas as pd
import matplotlib.pyplot as plt

ventas = pd.read_csv("ventas_mensuales.csv")
ventas["total"] = ventas["unidades"] * ventas["precio_unitario"]

# Tres pasos antes de dibujar, y ninguno es opcional:
#   convertir a fecha real, descartar lo que no es una fecha, y agrupar al
#   grano que el grafico necesita, que es un punto por dia.
fecha = pd.to_datetime(ventas["fecha"], format="%Y-%m-%d", errors="coerce")
print("fechas que no se pudieron convertir:", int(fecha.isna().sum()))
print(ventas.loc[fecha.isna(), "fecha"].to_list())

diario = (ventas.assign(fecha=fecha)
          .dropna(subset=["fecha"])
          .groupby("fecha")["total"].sum()
          .sort_index())

fig, ax = plt.subplots()
ax.plot(diario.index, diario.to_numpy(), linewidth=1)
ax.set_title("Ventas diarias del primer trimestre")
ax.set_xlabel("Fecha")
ax.set_ylabel("Importe del dia")
ax.grid(axis="y", alpha=0.3)
fig.tight_layout()
plt.show()

print()
print("dias con al menos una venta:", len(diario))
print("del", diario.index.min().date(), "al", diario.index.max().date())
print("dias del periodo:", (diario.index.max() - diario.index.min()).days + 1)
print()
print(diario.describe().round(2).to_string())
print()
print("El eje ya esta en fechas de verdad: matplotlib reparte enero, febrero y")
print("marzo segun cuantos dias tiene cada uno, no segun cuantas filas hay.")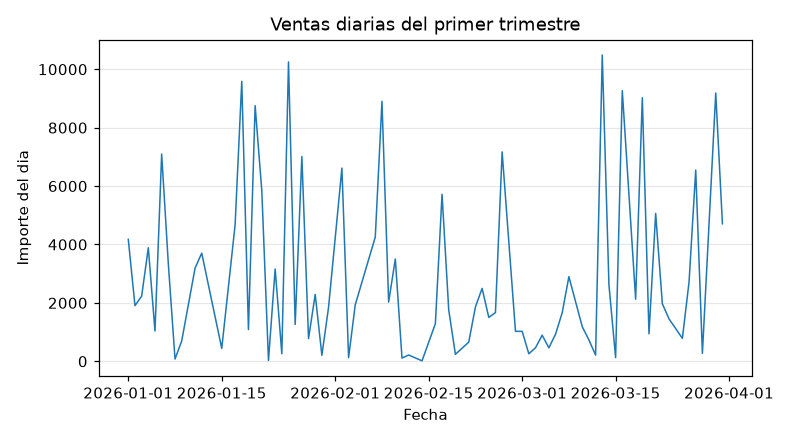
fechas que no se pudieron convertir: 6
[nan, '2026-02-30', nan, '15/03/2026', nan, nan]

dias con al menos una venta: 75
del 2026-01-01 al 2026-03-31
dias del periodo: 90

count       75.00
mean      2932.26
std       2954.29
min         15.62
25%        754.64
50%       1862.41
75%       4216.37
max      10489.38

El eje ya esta en fechas de verdad: matplotlib reparte enero, febrero y
marzo segun cuantos dias tiene cada uno, no segun cuantas filas hay.
Seis fechas no se pudieron convertir: cuatro vacías, un 2026-02-30 que
no existe y un 15/03/2026 escrito en otro formato. Con
errors="coerce" quedan como NaT y se descartan, y eso hay que
informarlo: seis ventas quedaron fuera del gráfico. Un gráfico que
tapa seis filas sin decirlo es exactamente el tipo de error que después nadie
encuentra.
Los días que no están en el archivo
import pandas as pd
import matplotlib.pyplot as plt

ventas = pd.read_csv("ventas_mensuales.csv")
ventas["total"] = ventas["unidades"] * ventas["precio_unitario"]
fecha = pd.to_datetime(ventas["fecha"], format="%Y-%m-%d", errors="coerce")

diario = (ventas.assign(fecha=fecha)
          .dropna(subset=["fecha"])
          .groupby("fecha")["total"].sum())

# groupby solo devuelve los dias que aparecen en el archivo. La linea los une
# igual, y al hacerlo dibuja una recta sobre los dias que faltan como si no
# hubiera pasado nada. resample("D") pone esos dias en la serie.
completo = diario.resample("D").sum()
print("dias con venta:", len(diario), " dias del calendario:", len(completo))
print("dias sin ninguna venta:", int((completo == 0).sum()))

movil = completo.rolling(7, min_periods=7).mean()

fig, ax = plt.subplots()
ax.plot(completo.index, completo.to_numpy(), color="0.7", linewidth=1,
        label="Ventas del dia")
ax.plot(movil.index, movil.to_numpy(), color="crimson", linewidth=2.5,
        label="Media movil de 7 dias")
ax.set_title("Ventas diarias y tendencia semanal")
ax.set_xlabel("Fecha")
ax.set_ylabel("Importe del dia")
ax.legend()
fig.tight_layout()
plt.show()

print()
print("dias sin venta, primeros cinco:")
print([str(d.date()) for d in completo.index[completo == 0][:5]])
print()
print("media movil, ultimos siete valores:")
print(movil.dropna().tail(7).round(2).to_string())
print()
print("La serie gris no tiene forma. La media movil dice que, con todo el")
print("ruido de los dias sueltos, el nivel del trimestre casi no se mueve.")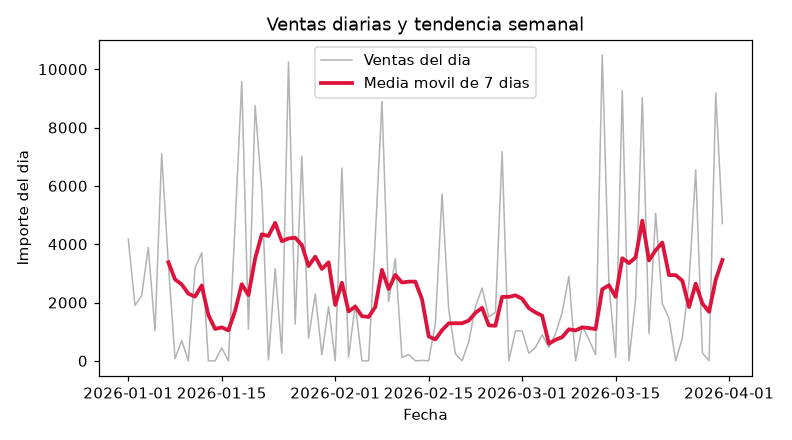
dias con venta: 75  dias del calendario: 90
dias sin ninguna venta: 15

dias sin venta, primeros cinco:
['2026-01-10', '2026-01-13', '2026-01-14', '2026-01-16', '2026-02-01']

media movil, ultimos siete valores:
fecha
2026-03-25    2747.61
2026-03-26    1846.01
2026-03-27    2647.11
2026-03-28    1963.05
2026-03-29    1681.82
2026-03-30    2786.77
2026-03-31    3459.31
Freq: D

La serie gris no tiene forma. La media movil dice que, con todo el
ruido de los dias sueltos, el nivel del trimestre casi no se mueve.groupby("fecha") devuelve 75 días porque son los que aparecen en el
archivo. El período tiene 90. Los 15 días sin ventas no se dibujan como
huecos: se dibujan como una recta que va del día anterior al siguiente, y esa
recta parece un dato.
resample("D").sum() pone esos días en la serie con valor cero. Ahora
bien, cuidado: un cero solo es correcto si «no hay fila» significa
«no hubo venta». Si significa «ese día no se cargaron los datos», el valor
correcto es NaN, que Matplotlib dibuja como hueco de verdad. Los dos casos
existen y el archivo no te lo dice: lo tenés que saber vos.
Acá hay que elegir
Una ventana chica sigue el ruido; una grande borra los cambios reales. Siete días es la elección obvia cuando hay efecto de día de semana, porque cada ventana contiene exactamente un sábado y un domingo. Doce meses cumple el mismo papel con datos mensuales estacionales.
Cuando no hay un ciclo natural, no hay respuesta correcta: hay una elección que se declara. «Media móvil de 7 días» escrito en la leyenda es suficiente; «serie suavizada» no lo es.
Dónde se rompe
Causa: el eje horizontal es texto y las filas no están ordenadas. Cada fecha es una categoría en el orden de aparición.
Arreglo: pd.to_datetime(...) y sort_index().
Con fechas de verdad, Matplotlib ordena y reparte por tiempo real.
Causa: eje categórico. Cada categoría ocupa el mismo ancho, así que el espacio depende de cuántas filas hay, no de cuánto tiempo pasó.
Arreglo: el mismo. Con un eje de fechas, tres días sin datos ocupan tres días de ancho.
Causa: groupby solo devuelve las claves que existen. La línea
une el día 9 con el día 11 sin marcar nada.
Arreglo: resample("D"). Con .sum() si el hueco
es un cero real; dejando NaN si el hueco es falta de dato.
Causa: la media móvil con mode="valid" devuelve menos puntos
que la serie.
Arreglo: recortar el eje horizontal igual: dias.iloc[3:] con
ventana 4. El error acá es una buena noticia: te obliga a pensar en la
alineación.
Causa: la ventana es tan grande que se comió el período que estás mirando, o tan chica que estás leyendo ruido como tendencia.
Arreglo: probá dos o tres ventanas y mirá cuál sobrevive. Si la conclusión depende de la ventana, la conclusión es que no hay tendencia clara, y eso también es un resultado.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
pd.to_datetime(s, format=..., errors="coerce") | Texto a fecha; lo que falla queda NaT | Siempre, antes de graficar |
s.isna().sum() | Cuántas no se pudieron convertir | Para informarlo, no para taparlo |
df.groupby("fecha")["v"].sum() | Un punto por día | Cuando cada fila es un hecho, no un día |
serie.sort_index() | Orden cronológico | Después de agrupar |
serie.resample("D").sum() | Agrega los días faltantes con cero | Si «sin fila» significa «sin actividad» |
serie.resample("D").asfreq() | Agrega los faltantes como NaN | Si «sin fila» significa «sin dato» |
serie.resample("ME").sum() | Un punto por mes | Cuando el día es demasiado ruido |
serie.rolling(7, min_periods=7).mean() | Media móvil alineada sola | La forma cómoda, con índice de fecha |
np.convolve(v, np.ones(4)/4, mode="valid") | Media móvil sobre un array | Sin índice; hay que alinear a mano |
ax.plot(x, y, linewidth=1) | Línea fina para la serie cruda | Cuando hay una línea gruesa encima |
ax.axvline(fecha, linestyle="--") | Marca una fecha | Señalar cuándo cambió algo |
fig.autofmt_xdate() | Inclina las fechas del eje | Cuando se pisan |