Indice / Visualizacion con Seaborn / 9.4
Varias variables a la vez
Dos variables entran en una dispersión. Tres o cuatro también, si cada una usa un canal visual distinto. Diez no entran en ningún gráfico, y conviene saber dónde está el límite antes de cruzarlo.
Para qué sirve
Un análisis real empieza con una tabla de ocho o doce columnas y la pregunta «¿qué hay acá?». El mapa de calor de la lección anterior contesta parte: qué se mueve junto con qué, en un número por par. Lo que no contesta es cómo: si la relación es recta o curva, si hay grupos separados, si un par de puntos sostiene todo.
El pairplot dibuja todas las dispersiones de a pares en una sola figura y
pone la distribución de cada variable en la diagonal. Es la versión visual de la matriz
de correlación.
El ejemplo mínimo
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

estudio = pd.DataFrame({
    "horas": [2, 3, 4, 5, 5, 6, 7, 8, 9, 10, 11, 12],
    "nota": [52, 55, 60, 62, 68, 70, 74, 78, 83, 85, 89, 92],
    "proyectos": [1, 1, 2, 2, 3, 2, 3, 4, 3, 4, 5, 5],
    "curso": ["Datos", "Software", "IA"] * 4})

variables = ["horas", "nota", "proyectos"]
print("correlaciones equivalentes a lo que dibuja la matriz:")
print(estudio[variables].corr().round(3).to_string())
print("\nobservaciones por curso:")
print(estudio["curso"].value_counts().sort_index().to_string())

g = sns.pairplot(estudio, vars=variables, hue="curso",
                 corner=True, diag_kind="hist", height=2.0)
# pairplot es figure-level: crea su figura y no acepta ax=. El ancho se fija
# despues, sobre g.figure, para que todas las paginas midan lo mismo.
g.figure.set_size_inches(7.2, 5.6)
g.figure.suptitle("Relaciones por pares, por curso", y=1.0)
g.figure.tight_layout()
plt.show()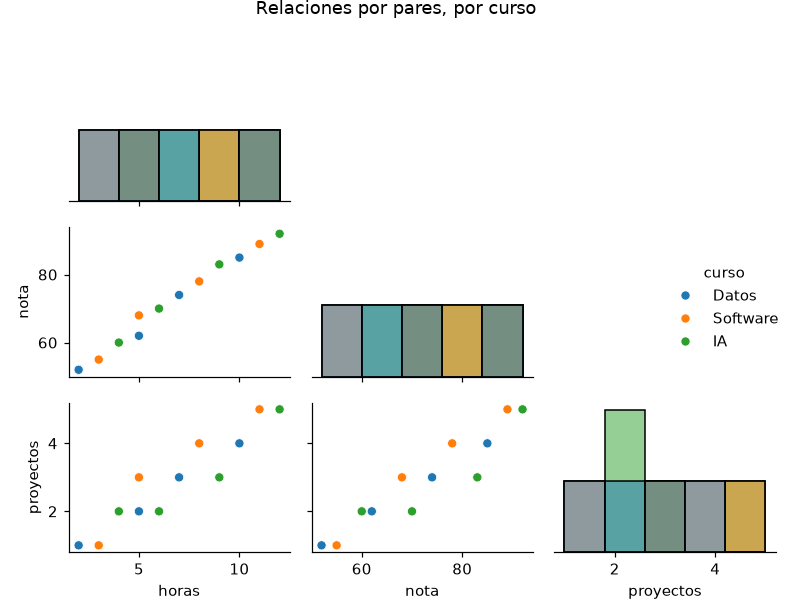
correlaciones equivalentes a lo que dibuja la matriz:
           horas   nota  proyectos
horas      1.000  0.992      0.940
nota       0.992  1.000      0.942
proyectos  0.940  0.942      1.000

observaciones por curso:
curso
Datos       4
IA          4
Software    4
Tres cosas del ejemplo merecen nombre propio:
vars=elige las columnas. Sin eso,pairplottoma todas las numéricas, incluidos los identificadores, y dibuja la dispersión deproducto_idcontracliente_id, que no significa nada.corner=Truedibuja media matriz. La mitad de arriba es la de abajo con los ejes dados vuelta: la misma información, el doble de tinta.diag_kind="hist"pone un histograma en la diagonal, que es donde una variable se cruza consigo misma. La alternativa es"kde", con la misma advertencia sobre densidades estimadas que en la lección anterior.
pairplot es figure-level, y eso cambia cómo se lo trata
No acepta ax= y no devuelve Axes: crea su propia figura y
devuelve un PairGrid. Por eso el título se pone con
g.figure.suptitle(...) y no con ax.set_title(...).
Y por eso también hay que fijarle el tamaño a mano: height controla cada
celda, no el total. El ejemplo cierra con
g.figure.set_size_inches(7.2, 5.6), que es lo que mantiene todas las figuras
del curso en el mismo ancho.
Sobre datos de verdad
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

hechos = pd.read_csv("dw_hecho_ventas.csv")
productos = pd.read_csv("dw_dim_producto.csv")

# Mismo criterio que en 9.2: el dominio del ingreso llega a 100000.
valido = hechos["ingreso"].between(0, 100000) & hechos["cantidad"].notna()
print("filas descartadas por dominio o ausencia:", int((~valido).sum()))

ventas = (hechos[valido]
          .merge(productos[["producto_id", "categoria"]],
                 on="producto_id", how="left"))
print("ventas sin categoria:", int(ventas["categoria"].isna().sum()))

ventas = ventas.dropna(subset=["categoria", "costo"])
print("filas que entran al grafico:", len(ventas))
print("\nobservaciones por categoria:")
print(ventas["categoria"].value_counts().sort_index().to_string())

variables = ["cantidad", "ingreso", "costo"]
print("\ncorrelaciones sobre lo que queda:")
print(ventas[variables].corr().round(3).to_string())

g = sns.pairplot(ventas, vars=variables, hue="categoria",
                 corner=True, diag_kind="hist", height=2.0,
                 plot_kws={"alpha": 0.45, "s": 18})
g.figure.set_size_inches(7.2, 5.6)
g.figure.suptitle("Medidas de venta por categoria de producto", y=1.0)
g.figure.tight_layout()
plt.show()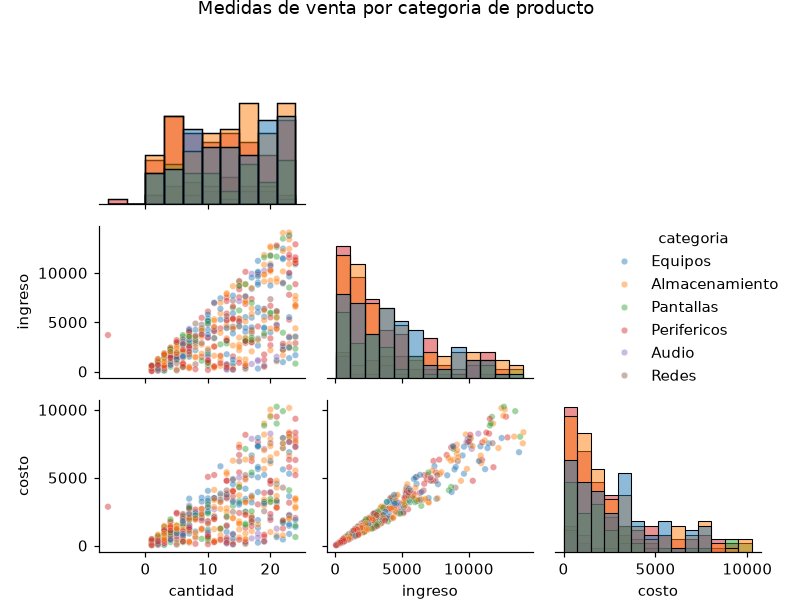
filas descartadas por dominio o ausencia: 3
ventas sin categoria: 25
filas que entran al grafico: 470

observaciones por categoria:
categoria
Almacenamiento    138
Audio              17
Equipos           108
Pantallas          57
Perifericos       121
Redes              29

correlaciones sobre lo que queda:
          cantidad  ingreso  costo
cantidad     1.000    0.645  0.617
ingreso      0.645    1.000  0.969
costo        0.617    0.969  1.000
Acá se ve por qué la limpieza va antes del gráfico y no después. Tres filas salen por
dominio, veinticinco ventas apuntan a un producto que no existe en la dimensión, y las
470 que quedan muestran lo que la lección 9.2 ya había encontrado:
ingreso contra costo en 0,969, una banda casi
perfecta.
Fijate en las 25 huérfanas. Un merge con how="left" las deja
con la categoría en NaN, y pairplot con hue
simplemente no las dibuja. Sin ese isna().sum() impreso, 25 ventas
desaparecen del análisis y nadie se entera. Es el mismo modo de falla de la unidad 6.
Con n variables dibuja n por n celdas. Con 5 son 25, con 10 son 100 y con 30 son 900: la figura tarda, pesa y no se puede leer. No es una limitación de la biblioteca, es del ojo.
El orden útil es al revés del intuitivo: primero la matriz de correlación, que
sí soporta muchas variables, y con eso se eligen las tres o cuatro que valen un
pairplot.
La idea: una variable por canal visual
La otra manera de meter más variables en un gráfico es usar los canales que una nube de puntos tiene libres. La posición ya está ocupada por dos. Quedan el color, el tamaño y la forma.
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

estudio = pd.DataFrame({
    "horas": [2, 3, 4, 5, 5, 6, 7, 8, 9, 10, 11, 12],
    "nota": [52, 55, 60, 62, 68, 70, 74, 78, 83, 85, 89, 92],
    "proyectos": [1, 1, 2, 2, 3, 2, 3, 4, 3, 4, 5, 5],
    "curso": ["Datos", "Software", "IA"] * 4})

print("lo que codifica cada canal visual:")
print("  posicion x -> horas   ", list(estudio["horas"]))
print("  posicion y -> nota    ", list(estudio["nota"]))
print("  tamano     -> proyectos", list(estudio["proyectos"]))
print("  color/forma-> curso   ", sorted(estudio["curso"].unique()))

extremos = estudio.nlargest(3, "nota")[["curso", "horas", "nota", "proyectos"]]
print("\nlos tres de nota mas alta:")
print(extremos.to_string(index=False))

fig, ax = plt.subplots()
sns.scatterplot(data=estudio, x="horas", y="nota", hue="curso",
                size="proyectos", style="curso", sizes=(40, 220),
                alpha=0.78, ax=ax)
ax.set_title("Horas, nota, curso y proyectos en un grafico")
ax.set_xlabel("Horas por semana")
ax.set_ylabel("Nota sobre 100")
ax.legend(bbox_to_anchor=(1.02, 1), loc="upper left", borderaxespad=0, fontsize=8)
fig.tight_layout()
plt.show()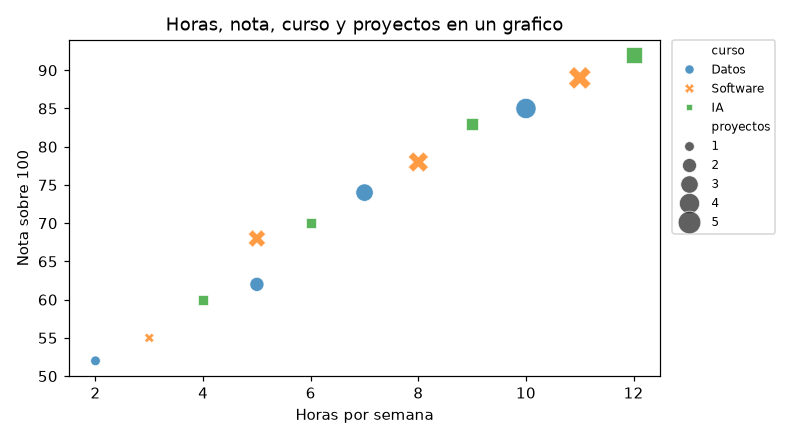
lo que codifica cada canal visual:
  posicion x -> horas    [2, 3, 4, 5, 5, 6, 7, 8, 9, 10, 11, 12]
  posicion y -> nota     [52, 55, 60, 62, 68, 70, 74, 78, 83, 85, 89, 92]
  tamano     -> proyectos [1, 1, 2, 2, 3, 2, 3, 4, 3, 4, 5, 5]
  color/forma-> curso    ['Datos', 'IA', 'Software']

los tres de nota mas alta:
   curso  horas  nota  proyectos
      IA     12    92          5
Software     11    89          5
   Datos     10    85          4
Cuatro variables en un gráfico que se sigue leyendo. La regla que lo hace posible es que cada canal lleva exactamente una variable, y que cada variable va al canal que le corresponde:
- Posición: las dos cuantitativas principales. Es el canal que el ojo compara con más precisión, así que se reserva para lo que más importa.
- Color: una categoría, y con pocos niveles. Tres o cuatro se distinguen; doce no.
- Tamaño: una magnitud positiva y comparable. El área se percibe peor que la posición, así que sirve para «más o menos», no para leer valores.
- Forma: otra categoría, o la misma que el color para reforzarla. Que es lo que hace el ejemplo, y es útil para quien no distingue bien los colores.
Cuando se cruza el límite
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

ventas = pd.DataFrame({
    "visitas": [120, 150, 180, 210, 240, 270, 300, 330, 360, 390, 420, 450],
    "conversion": [2.1, 2.4, 2.6, 3.0, 3.1, 3.6, 3.8, 4.2, 4.4, 4.9, 5.1, 5.5],
    "region": ["Norte", "Sur", "Centro"] * 4,
    "canal": ["Web", "App"] * 6,
    "equipo": list("ABCDEFGHIJKL")})

print("niveles por variable categorica:")
for col in ["region", "canal", "equipo"]:
    print("  %-8s %2d niveles" % (col, ventas[col].nunique()))
print("\nEl panel de la izquierda mapea las tres a la vez mas el tamano:")
print("  12 niveles de equipo en el color es mas de lo que el ojo separa.")
print("\nconversion media por region:")
print(ventas.groupby("region")["conversion"].mean().round(2).to_string())

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4), sharey=True)

sns.scatterplot(data=ventas, x="visitas", y="conversion", hue="equipo",
                style="canal", size="visitas", sizes=(30, 260),
                legend=False, ax=axes[0])
axes[0].set_title("Seis canales: ilegible")
axes[0].set_xlabel("Visitas")
axes[0].set_ylabel("Conversion (%)")

sns.scatterplot(data=ventas, x="visitas", y="conversion", hue="region",
                s=80, alpha=0.85, ax=axes[1])
axes[1].set_title("Uno por variable: se lee")
axes[1].set_xlabel("Visitas")
axes[1].legend(title="region", fontsize=8)

fig.tight_layout()
plt.show()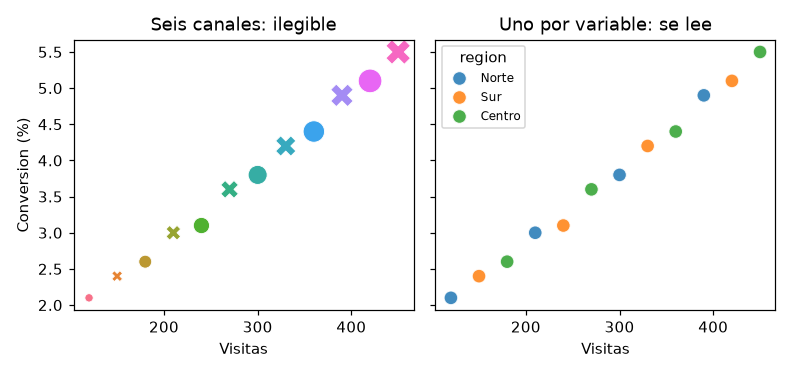
niveles por variable categorica:
  region    3 niveles
  canal     2 niveles
  equipo   12 niveles

El panel de la izquierda mapea las tres a la vez mas el tamano:
  12 niveles de equipo en el color es mas de lo que el ojo separa.

conversion media por region:
region
Centro    4.03
Norte     3.45
Sur       3.70
El panel de la izquierda tiene los mismos doce puntos que el de la derecha. Le mapea doce niveles de equipo al color, dos de canal a la forma y las visitas al tamaño, además de a la posición x. No hay nada roto: hay demasiado.
El de la derecha usa un canal para una variable y contesta una pregunta. Esa es toda la diferencia, y el número que la explica está impreso arriba del gráfico: doce niveles en el color es más de lo que el ojo separa.
Acá hay que elegir
Cuando hay más variables que canales razonables, hay tres salidas:
- Facetas (
sns.relplot(..., col="region")): un panel por nivel de la categoría, todos con los mismos ejes. Es lo mejor cuando la categoría tiene entre tres y ocho niveles y querés comparar la misma relación entre grupos. - Más canales: sirve hasta cuatro variables, y con la disciplina de una por canal. Más allá, el gráfico deja de responder preguntas.
- Varios gráficos separados: cuando las preguntas son distintas. Un panel de cuatro gráficos que contestan cuatro preguntas se lee mejor que un gráfico que intenta contestar las cuatro.
La pregunta que ordena la elección no es «¿cuántas variables tengo?» sino «¿cuántas preguntas estoy haciendo?». Una por gráfico.
Dónde se rompe
Causa: pairplot es figure-level y no devuelve Axes.
Arreglo: g.figure.suptitle("..."). Lo mismo vale para
relplot, catplot y displot.
Causa: intentaste meterlo en un panel armado con plt.subplots.
Arreglo: no se puede, y no es un olvido de la biblioteca. Si necesitás el panel, armalo con funciones axes-level.
Causa: demasiadas columnas. Sin vars toma todas las numéricas,
identificadores incluidos.
Arreglo: vars=[...] con tres o cuatro columnas, elegidas a
partir de la matriz de correlación.
Causa: la columna de hue tiene NaN, casi siempre
por un merge con filas huérfanas. Seaborn no dibuja esas filas.
Arreglo: contá los NaN antes, decidí si van a una categoría
«sin dato» o se descartan, e informá cuántos fueron.
Causa: hue más size generan dos bloques de
leyenda, y por defecto van adentro de los ejes.
Arreglo: ax.legend(bbox_to_anchor=(1.02, 1), loc="upper left")
para sacarla afuera, y fig.tight_layout() después.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
sns.pairplot(df, vars=[...]) | Todas las dispersiones por pares | Tres o cuatro variables |
corner=True | Solo el triángulo inferior | Casi siempre: la otra mitad repite |
diag_kind="hist" | Histograma en la diagonal | Ver la forma de cada variable |
hue="cat" | Colorea por categoría | Pocos niveles |
plot_kws={"alpha": 0.45, "s": 18} | Pasa opciones a los puntos | Cientos de observaciones |
g.figure.set_size_inches(7.2, 5.6) | Fija el tamaño total | Obligatorio en figure-level |
g.figure.suptitle("...") | Título de la figura entera | Ídem |
sns.scatterplot(..., hue=, size=, style=) | Hasta cuatro variables | Una por canal, sin excepción |
sizes=(40, 220) | Rango de área de los marcadores | Junto con size |
sns.relplot(data=df, x=, y=, col="cat") | Un panel por nivel | Comparar la misma relación entre grupos |
col_wrap=3 | Corta las facetas en filas de tres | Muchos niveles |
ax.legend(bbox_to_anchor=(1.02, 1)) | Saca la leyenda afuera | Cuando tapa los datos |