Indice / Visualizacion con Matplotlib / 8.7
Bandas y anomalías: la variabilidad en el gráfico
Una línea de promedios dice dónde está el centro. La banda dice cuánto se aparta lo que hay alrededor, y es lo que convierte un gráfico bonito en uno que sirve para decidir.
Para qué sirve
Un promedio por hora, por semana o por sucursal es una línea limpia y tranquilizadora que esconde exactamente el dato que hace falta para operar: qué tan distinto puede salir el próximo caso. Una entrega que tarda 30 minutos en promedio con un desvío de 2 y otra con un desvío de 20 son dos negocios distintos, y la línea de promedios es idéntica.
Y de la misma medida sale lo segundo: si sabés cuánto se aparta lo normal, podés marcar lo que se aparta demasiado. Esa es la parte de anomalías.
El ejemplo mínimo
import pandas as pd
import matplotlib.pyplot as plt

pedidos = pd.DataFrame({
    "semana": [1] * 7 + [2] * 7 + [3] * 7 + [4] * 7 + [5] * 7 + [6] * 7,
    "pedidos": [98, 102, 101, 99, 103, 100, 97, 104, 108, 105, 110, 107, 106,
                109, 111, 115, 117, 113, 116, 114, 118, 120, 123, 119, 126,
                124, 122, 127, 128, 133, 130, 136, 129, 138, 132, 139, 145,
                137, 149, 141, 151, 143]})

resumen = pedidos.groupby("semana")["pedidos"].agg(["mean", "std"])

fig, axes = plt.subplots(2, 1, figsize=(7.2, 4.8), sharex=True)

axes[0].plot(resumen.index, resumen["mean"], color="steelblue", marker="o")
axes[0].fill_between(resumen.index,
                     resumen["mean"] - resumen["std"],
                     resumen["mean"] + resumen["std"],
                     color="steelblue", alpha=0.2,
                     label="Media mas menos un desvio")
axes[0].set_title("El nivel sube y la variabilidad tambien")
axes[0].set_ylabel("Pedidos por dia")
axes[0].legend()

axes[1].bar(resumen.index, resumen["std"], color="darkorange")
axes[1].set_xlabel("Semana")
axes[1].set_ylabel("Desvio")

fig.tight_layout()
plt.show()

print(resumen.round(2).to_string())
print()
print("La media crece de", round(resumen["mean"].iloc[0], 1), "a",
      round(resumen["mean"].iloc[-1], 1), "pedidos por dia.")
print("El desvio crece de", round(resumen["std"].iloc[0], 2), "a",
      round(resumen["std"].iloc[-1], 2), ".")
print()
print("La banda dice cuanto se puede esperar que se aparte un dia cualquiera.")
print("Una banda que se ensancha es una operacion cada vez menos previsible,")
print("aunque el promedio mejore.")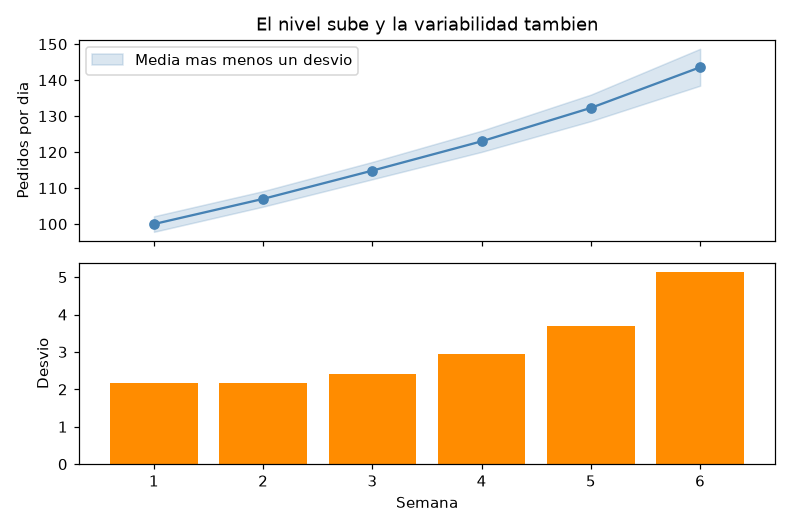
          mean   std
semana
1       100.00  2.16
2       107.00  2.16
3       114.86  2.41
4       123.00  2.94
5       132.29  3.68
6       143.57  5.13

La media crece de 100.0 a 143.6 pedidos por dia.
El desvio crece de 2.16 a 5.13 .

La banda dice cuanto se puede esperar que se aparte un dia cualquiera.
Una banda que se ensancha es una operacion cada vez menos previsible,
aunque el promedio mejore.
La media crece de 100 a 143,6 pedidos por día. El desvío crece de 2,16 a 5,13. Las dos cosas son ciertas al mismo tiempo y cuentan historias opuestas: el centro logístico mueve más volumen y se volvió menos previsible. La banda que se ensancha es el hallazgo, y sin ella el gráfico habría dicho solamente «vamos bien».
ELI5Explicado facil
Pensá en el tiempo que tardás en llegar a la facultad.
- Si siempre tardás 30 minutos, salís 35 minutos antes y llegás.
- Si tardás 30 en promedio, pero a veces 20 y a veces 50, tenés que salir 55 minutos antes. El promedio es el mismo y la vida es otra.
La banda del gráfico es eso: el «a veces». Sin ella, un promedio te hace llegar tarde una de cada cinco veces.
Sobre datos de verdad
Una lectura imposible y la banda se traga el gráfico
import pandas as pd
import matplotlib.pyplot as plt

sensores = pd.read_csv("numpy_sensores.csv")
horas = [c for c in sensores.columns if c.startswith("h")]
lecturas = sensores[horas]
eje = [int(h[1:]) for h in horas]

media = lecturas.mean()
desvio = lecturas.std()

fig, ax = plt.subplots()
ax.plot(eje, media.to_numpy(), color="steelblue", marker="o", markersize=3)
ax.fill_between(eje, (media - desvio).to_numpy(), (media + desvio).to_numpy(),
                color="steelblue", alpha=0.2)
ax.set_title("Temperatura media por hora, sin filtrar")
ax.set_xlabel("Hora del dia")
ax.set_ylabel("Grados Celsius")
fig.tight_layout()
plt.show()

print("hora con el desvio mas alto:", desvio.idxmax(),
      "->", round(desvio.max(), 2), "grados")
print("desvio en el resto de las horas: entre",
      round(desvio.drop(desvio.idxmax()).min(), 2), "y",
      round(desvio.drop(desvio.idxmax()).max(), 2))
print()
print("De donde sale:")
sospechosa = sensores.loc[lecturas[desvio.idxmax()] > 60,
                          ["sensor_id", "ubicacion", desvio.idxmax()]]
print(sospechosa.to_string(index=False))
print()
peor = desvio.idxmax()
print("Una lectura de 999.9 en una sola hora de un solo sensor.")
print("Media de esa hora:", round(media[peor], 2),
      " | media del resto de las horas:",
      round(media.drop(peor).mean(), 2))
print("La banda se come todo el grafico y las otras 23 horas quedan")
print("aplastadas contra una linea.")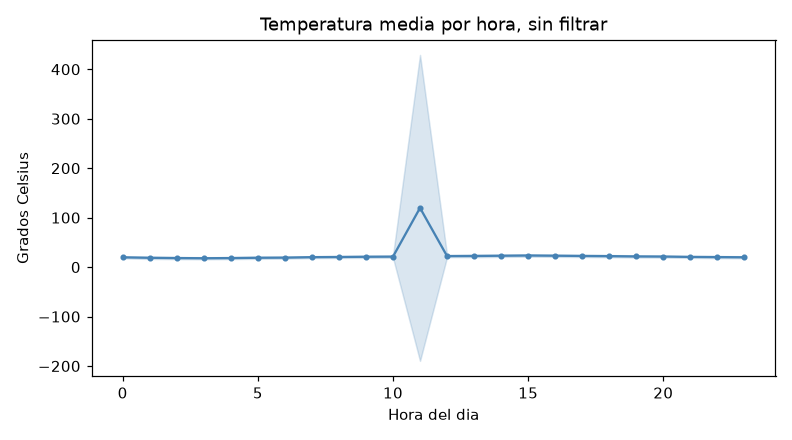
hora con el desvio mas alto: h11 -> 309.27 grados
desvio en el resto de las horas: entre 1.84 y 2.4

De donde sale:
sensor_id   ubicacion   h11
      S05 laboratorio 999.9

Una lectura de 999.9 en una sola hora de un solo sensor.
Media de esa hora: 119.72  | media del resto de las horas: 20.72
La banda se come todo el grafico y las otras 23 horas quedan
aplastadas contra una linea.
El desvío de las 11 es 309,27 grados; el de las otras veintitrés
horas está entre 1,84 y 2,4. La media de esa hora salta de unos 21 grados a 119,72. Es
un único 999.9 en un único sensor, y basta para que la banda cubra de −300
a +600 grados y las veintitrés horas restantes queden aplastadas contra una línea.
Los dos suman todos los valores, así que un valor extremo entra entero. El desvío además eleva al cuadrado la distancia al centro, con lo cual un valor mil veces más grande pesa un millón de veces más.
La mediana y el rango intercuartílico no tienen ese problema: cambian poco aunque el máximo sea absurdo. Son robustos. La contra es que son menos familiares y que no se combinan tan bien con el resto del análisis, así que la solución habitual sigue siendo limpiar primero y usar media y desvío después.
Con la lectura imposible afuera
import pandas as pd
import matplotlib.pyplot as plt

sensores = pd.read_csv("numpy_sensores.csv")
horas = [c for c in sensores.columns if c.startswith("h")]
eje = [int(h[1:]) for h in horas]

# Politica: este edificio no supera los 60 grados en ninguna sala. Lo que pasa
# de ahi es una lectura rota del sensor, no una temperatura.
crudo = sensores[horas]
lecturas = crudo.mask(crudo > 60)
print("lecturas anuladas por imposibles:", int((crudo > 60).sum().sum()))
print("lecturas ausentes en el archivo:", int(crudo.isna().sum().sum()))
print("lecturas usadas:", int(lecturas.notna().sum().sum()), "de",
      lecturas.size)

media = lecturas.mean()
desvio = lecturas.std()

fig, ax = plt.subplots()
for _, fila in lecturas.iterrows():
    ax.plot(eje, fila.to_numpy(), color="0.8", linewidth=0.8)
ax.fill_between(eje, (media - desvio).to_numpy(), (media + desvio).to_numpy(),
                color="steelblue", alpha=0.25,
                label="Media mas menos un desvio")
ax.plot(eje, media.to_numpy(), color="steelblue", linewidth=2.5,
        label="Media de los diez sensores")
ax.set_title("El edificio se enfria de madrugada y se calienta hasta las 16")
ax.set_xlabel("Hora del dia")
ax.set_ylabel("Grados Celsius")
ax.set_xticks(range(0, 24, 3))
ax.legend()
fig.tight_layout()
plt.show()

print()
print("hora mas fria:", media.idxmin(), round(media.min(), 2))
print("hora mas calida:", media.idxmax(), round(media.max(), 2))
print("desvio, minimo y maximo:", round(desvio.min(), 2), round(desvio.max(), 2))
print()
print("Ahora el desvio esta entre", round(desvio.min(), 1), "y",
      round(desvio.max(), 1), "grados, y la banda dice algo:")
print("a cualquier hora, las salas del edificio difieren entre si en")
print("ese orden de magnitud.")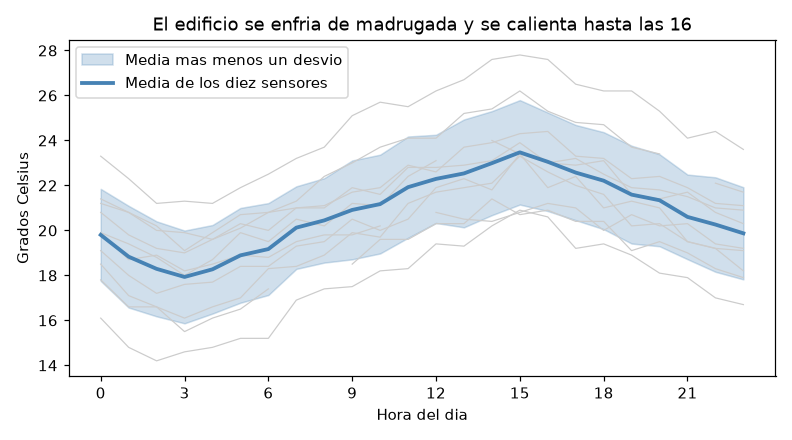
lecturas anuladas por imposibles: 1
lecturas ausentes en el archivo: 4
lecturas usadas: 235 de 240

hora mas fria: h03 17.93
hora mas calida: h15 23.47
desvio, minimo y maximo: 1.84 2.4

Ahora el desvio esta entre 1.8 y 2.4 grados, y la banda dice algo:
a cualquier hora, las salas del edificio difieren entre si en
ese orden de magnitud.
Una lectura anulada sobre 240 y el gráfico empieza a decir algo: el edificio se enfría hasta las 3 de la mañana, se calienta hasta un máximo a las 15 y las salas difieren entre sí en unos dos grados a cualquier hora. Las diez curvas grises detrás de la banda son las que permiten ver que hay una que va sistemáticamente por arriba, cosa que el promedio no muestra.
Marcar lo que se aparta
import pandas as pd
import matplotlib.pyplot as plt

sensores = pd.read_csv("numpy_sensores.csv")
horas = [c for c in sensores.columns if c.startswith("h")]
eje = [int(h[1:]) for h in horas]

crudo = sensores[horas]
lecturas = crudo.mask(crudo > 60)

todas = lecturas.stack()
media, desvio = todas.mean(), todas.std()
limite_alto, limite_bajo = media + 2 * desvio, media - 2 * desvio
z = (lecturas - media) / desvio
anomala = z.abs() > 2

# El mismo criterio, calculado sobre los datos sin filtrar.
sucias = crudo.stack()
z_sucio = (crudo - sucias.mean()) / sucias.std()
print("anomalias con el 999.9 adentro:", int((z_sucio.abs() > 2).sum().sum()))
print("anomalias con el 999.9 afuera: ", int(anomala.sum().sum()))

fig, ax = plt.subplots()
for indice, fila in lecturas.iterrows():
    ax.plot(eje, fila.to_numpy(), color="0.8", linewidth=0.8)
    marcadas = anomala.loc[indice]
    if marcadas.any():
        ax.scatter([int(h[1:]) for h in horas if marcadas[h]],
                   fila[marcadas].to_numpy(), color="red", s=28, zorder=3)
ax.axhline(limite_alto, color="crimson", linestyle="--",
           label=f"Media mas menos 2 desvios ({limite_bajo:.1f} a {limite_alto:.1f})")
ax.axhline(limite_bajo, color="crimson", linestyle="--")
ax.set_title("Catorce de las dieciseis anomalias vienen de dos sensores")
ax.set_xlabel("Hora del dia")
ax.set_ylabel("Grados Celsius")
ax.set_xticks(range(0, 24, 3))
ax.legend(loc="lower right")
fig.tight_layout()
plt.show()

print()
print("media:", round(media, 2), " desvio:", round(desvio, 2))
print("limites:", round(limite_bajo, 2), "a", round(limite_alto, 2))
print()
print("anomalias por sensor:")
por_sensor = anomala.sum(axis=1)
print(pd.DataFrame({"sensor": sensores["sensor_id"],
                    "ubicacion": sensores["ubicacion"],
                    "anomalas": por_sensor.to_numpy()})
      .query("anomalas > 0").to_string(index=False))
print()
print("Con el 999.9 adentro el desvio era", round(sucias.std(), 2),
      "y el corte alto estaba en",
      round(sucias.mean() + 2 * sucias.std(), 2), "grados:")
print("no marcaba a nadie. El unico dato imposible estaba escondiendo las")
print("lecturas raras de verdad, que es el modo mas caro de fallar: no se")
print("ve nada y todo parece en orden.")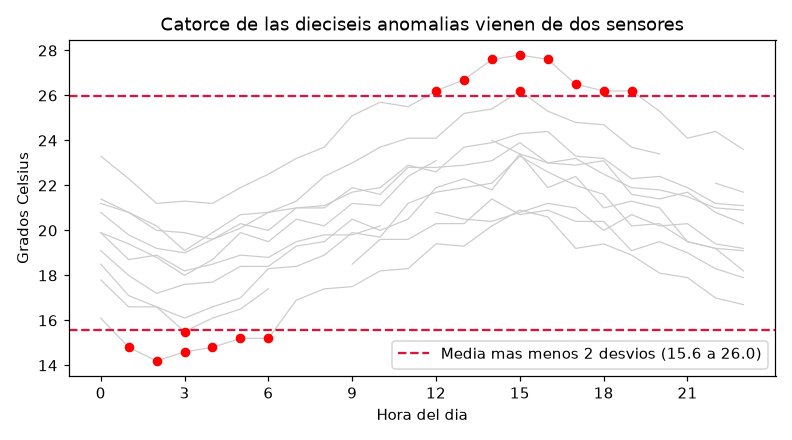
anomalias con el 999.9 adentro: 1
anomalias con el 999.9 afuera:  16

media: 20.76  desvio: 2.6
limites: 15.57 a 25.95

anomalias por sensor:
sensor       ubicacion  anomalas
   S03         oficina         1
   S07 sala_servidores         8
   S09     planta_baja         1
   S10     laboratorio         6

Con el 999.9 adentro el desvio era 63.79 y el corte alto estaba en 152.49 grados:
no marcaba a nadie. El unico dato imposible estaba escondiendo las
lecturas raras de verdad, que es el modo mas caro de fallar: no se
ve nada y todo parece en orden.Con el 999.9 adentro, el desvío global es 63,79 y el corte de dos
desvíos queda en 152,49 grados: no marca absolutamente nada. Sin él, el
corte queda en 25,95 y aparecen dieciséis lecturas fuera de rango, catorce de ellas en
apenas dos sensores.
Es el modo más caro de fallar. Un gráfico roto se nota; un detector de anomalías que no marca nada parece un sistema sano.
Y notá qué dicen las dieciséis: no están repartidas al azar. Ocho son de
S07, en la sala de servidores, y seis de S10, en el
laboratorio. Eso ya no es una anomalía estadística: es un patrón, y la
lectura correcta probablemente sea que esas dos salas simplemente funcionan a otra
temperatura y no pertenecen a la misma población que las demás.
Acá hay que elegir
El umbral de dos desvíos es una convención, igual que el 1,5 del IQR. Lo que casi nunca se discute y decide mucho más es respecto de qué media se calcula:
- La global, como en el ejemplo: marca los sensores que corren calientes o fríos respecto del edificio. Contesta «¿qué sala es distinta?».
- La de cada hora: marca el momento en que un sensor se apartó de lo que hacía el resto en ese momento. Contesta «¿cuándo pasó algo?».
- La de cada sensor: marca cuándo un sensor se apartó de sí mismo. Contesta «¿qué equipo cambió de comportamiento?».
Los tres dan conjuntos distintos de anomalías sobre los mismos datos, y ninguno es el correcto en abstracto. Lo correcto es elegir el que responde tu pregunta y escribir cuál elegiste.
Dónde se rompe
Causa: hay un valor extremo adentro del cálculo. Infla el desvío y corre el umbral tan lejos que nada lo alcanza.
Arreglo: descartar lo imposible antes de medir la dispersión. Es el mismo orden de la lección 5.6, y acá el costo de equivocarse es invisible.
Causa: la distribución no es acampanada. Con una cola larga, dos desvíos dejan afuera muchísimo más que el 5 % que uno esperaría.
Arreglo: mirá el histograma primero. Con colas largas conviene el IQR o trabajar sobre el logaritmo, y declararlo.
Causa: fill_between recibió un eje x de un largo y límites de
otro. Suele pasar tras un dropna aplicado a uno solo de los tres.
Arreglo: calcular media y desvío sobre el mismo objeto y usar su índice
como eje: ax.fill_between(media.index, media - sd, media + sd).
Causa: media menos un desvío da negativo, y una cantidad de pedidos no puede serlo.
Arreglo: recortar con .clip(lower=0) solo para
dibujar, y decirlo en el pie. La banda es una referencia, no una predicción, y
dibujar un imposible distrae.
Causa: ese grupo no pertenece a la misma población. La sala de servidores está más caliente siempre, y no es un evento.
Arreglo: calcular el umbral dentro de cada grupo, o excluir el grupo y tratarlo aparte. Que las anomalías se concentren es una señal de que el modelo de «normal» está mal armado, no de que pasaron muchas cosas.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
df.groupby(k)["v"].agg(["mean", "std"]) | Centro y dispersión por grupo | Base de la banda |
ax.fill_between(x, bajo, alto, alpha=0.2) | Área sombreada | Banda de referencia |
(bajo).clip(lower=0) | Impide que la banda baje de cero | Cantidades; se aclara |
ax.axhline(limite, linestyle="--") | Línea de corte | Umbral fijo |
(v - v.mean()) / v.std() | z-score | Distancia al centro en desvíos |
z.abs() > 2 | Máscara de anomalías | Umbral convencional; se declara |
df.mask(df > 60) | Anula lo imposible sin borrar la fila | Antes de medir dispersión |
ax.scatter(x[m], y[m], color="red", zorder=3) | Destaca los marcados | zorder los pone encima |
v.quantile([0.25, 0.75]) | Base del IQR | Alternativa robusta a media y desvío |
df.stack() | Todas las celdas en una serie | Estadística sobre la tabla entera |
plt.subplots(2, 1, sharex=True) | Dos ejes apilados | Serie arriba, dispersión abajo |