Indice / Visualizacion con Seaborn / 9.3
Caja y violín: la distribución por grupo
La caja resume cinco números y compara grupos de un vistazo. El precio que cobra por esa comodidad es esconder la forma, y a veces la forma es la noticia.
Para qué sirve
El histograma de la lección 8.5 muestra la forma de una variable. Cuando lo que hay que comparar es la misma variable en tres o siete grupos, apilar siete histogramas no funciona: no entran y no se comparan.
La caja resuelve eso reduciendo cada grupo a cinco números y dibujándolos en el mismo eje. Alcanza para responder cuál grupo está más arriba, cuál es más disperso y dónde hay observaciones que se escapan.
El ejemplo mínimo
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

notas = pd.DataFrame({
    "curso": ["Datos"] * 6 + ["Software"] * 6 + ["IA"] * 6,
    "nota": [58, 62, 65, 68, 71, 90,
             55, 60, 63, 66, 69, 72,
             70, 74, 77, 80, 83, 86]})

resumen = notas.groupby("curso")["nota"].describe()[["min", "25%", "50%", "75%", "max"]]
print("cuartiles por curso:")
print(resumen.round(2).to_string())

fig, ax = plt.subplots()
sns.boxplot(data=notas, x="curso", y="nota", hue="curso", legend=False, ax=ax)
sns.stripplot(data=notas, x="curso", y="nota", color="black", alpha=0.5,
              size=5, ax=ax)
ax.set_title("Notas por curso, con cada observacion encima")
ax.set_xlabel("Curso")
ax.set_ylabel("Nota sobre 100")
fig.tight_layout()
plt.show()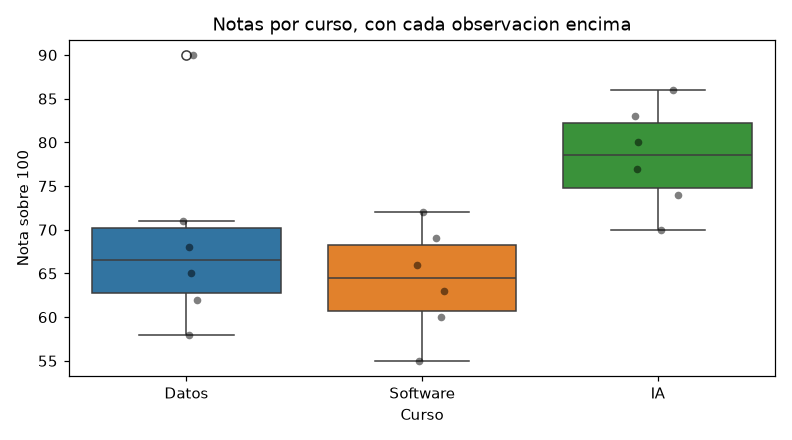
cuartiles por curso:
           min    25%   50%    75%   max
curso
Datos     58.0  62.75  66.5  70.25  90.0
IA        70.0  74.75  78.5  82.25  86.0
Software  55.0  60.75  64.5  68.25  72.0
Una caja se lee así, y conviene nombrar las partes en este orden:
- La línea del medio es la mediana, no la media. Es el valor que deja la mitad de las observaciones de cada lado.
- La caja va de Q1 a Q3 y contiene el 50 % central de los datos. Su altura es el rango intercuartílico.
- Los bigotes llegan hasta el dato más lejano que siga estando dentro de 1,5 veces el rango intercuartílico.
- Los puntos sueltos son los que caen fuera de esos bigotes.
El stripplot encima no es adorno: devuelve las observaciones que la caja
acaba de resumir. Con pocos datos por grupo es casi obligatorio.
La idea: lo que la caja esconde
Una caja se construye con cinco números. Cualquier cosa que esos cinco números no distingan, la caja no la distingue. El caso que más importa es la bimodalidad: dos poblaciones mezcladas en un mismo grupo.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

# Semilla explicita: sin ella el grafico cambiaria en cada corrida.
rng = np.random.default_rng(8)
presencial = rng.normal(8.0, 0.8, 80)
# Virtual mezcla dos poblaciones: quienes siguieron bien y quienes se colgaron.
virtual = np.concatenate([rng.normal(8.6, 0.5, 40), rng.normal(5.8, 0.5, 40)])

encuesta = pd.DataFrame({
    "modalidad": ["Presencial"] * 80 + ["Virtual"] * 80,
    "puntaje": np.clip(np.concatenate([presencial, virtual]), 1, 10)})

resumen = encuesta.groupby("modalidad")["puntaje"].agg(
    ["count", "mean", "median", "std"])
print("resumen por modalidad:")
print(resumen.round(3).to_string())
print("\nlas medianas quedan a menos de un punto; las formas, en nada.")
print("cuantos por debajo de 7:")
print(encuesta[encuesta["puntaje"] < 7]["modalidad"]
      .value_counts().sort_index().to_string())

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4), sharey=True)
sns.boxplot(data=encuesta, x="modalidad", y="puntaje",
            hue="modalidad", legend=False, ax=axes[0])
axes[0].set_title("Caja: dos resumenes parecidos")
axes[0].set_xlabel("")
axes[0].set_ylabel("Puntaje")
sns.violinplot(data=encuesta, x="modalidad", y="puntaje", inner="quart",
               hue="modalidad", legend=False, ax=axes[1])
axes[1].set_title("Violin: Virtual tiene dos grupos")
axes[1].set_xlabel("")
fig.tight_layout()
plt.show()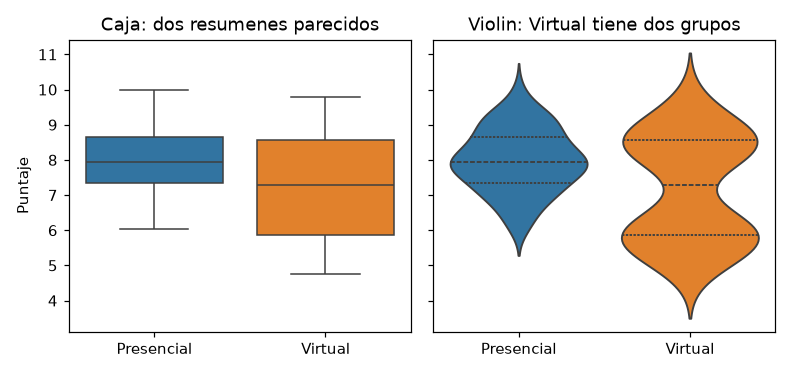
resumen por modalidad:
            count   mean  median    std
modalidad
Presencial     80  7.985   7.946  0.893
Virtual        80  7.176   7.299  1.495

las medianas quedan a menos de un punto; las formas, en nada.
cuantos por debajo de 7:
modalidad
Presencial    11
Virtual       40
Las dos modalidades tienen medianas a menos de un punto de distancia. Pero en Presencial hay 11 puntajes por debajo de 7 y en Virtual hay 40, la mitad exacta del grupo. La encuesta virtual no describe un curso que salió algo peor: describe dos grupos distintos, uno que siguió bien y otro que se quedó afuera, y el promedio cae justo en el medio, donde casi no hay nadie.
El violín dibuja la densidad estimada, así que esas dos panzas se ven. La caja las funde en un solo rectángulo.
inner="quart" devuelve lo que el violín se llevó
El violín gana forma y pierde los cuartiles. Con inner="quart" los
dibuja adentro como líneas punteadas, y así se tienen las dos lecturas en el mismo
gráfico. Las otras opciones son "box" (una caja chica adentro),
"point", "stick" y None.
Y una advertencia sobre el violín: la densidad es una estimación suavizada. Con pocos datos inventa curvas que no están en las observaciones, y suele extenderse más allá del mínimo y el máximo reales. Con menos de veinte o treinta observaciones por grupo, el violín promete más precisión de la que tiene.
Sobre datos de verdad
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

ops = pd.read_csv("transacciones_categorias.csv")
importe = pd.to_numeric(ops["importe"], errors="coerce")
print("filas:", len(ops), "| importe no numerico o ausente:", int(importe.isna().sum()))

datos = ops.assign(importe=importe).dropna(subset=["importe"])
print("filas que quedan:", len(datos))

# Regla de Tukey: atipico es lo que cae fuera de 1,5 veces el rango
# intercuartilico. Es la misma que dibuja los bigotes de la caja.
q1 = datos.groupby("categoria")["importe"].quantile(0.25)
q3 = datos.groupby("categoria")["importe"].quantile(0.75)
iqr = q3 - q1
limites = pd.DataFrame({"q1": q1, "q3": q3, "iqr": iqr,
                        "limite_bajo": q1 - 1.5 * iqr,
                        "limite_alto": q3 + 1.5 * iqr})
print("\nlimites por categoria:")
print(limites.round(2).to_string())

fuera = datos.merge(limites, left_on="categoria", right_index=True)
fuera = fuera[(fuera["importe"] < fuera["limite_bajo"]) |
              (fuera["importe"] > fuera["limite_alto"])]
print("\natipicos por categoria:")
print(fuera["categoria"].value_counts().sort_index().to_string())

fig, ax = plt.subplots()
sns.boxplot(data=datos, x="categoria", y="importe",
            hue="categoria", legend=False, ax=ax)
ax.set_title("Importe por categoria")
ax.set_xlabel("Categoria")
ax.set_ylabel("Importe")
ax.tick_params(axis="x", rotation=30)
fig.tight_layout()
plt.show()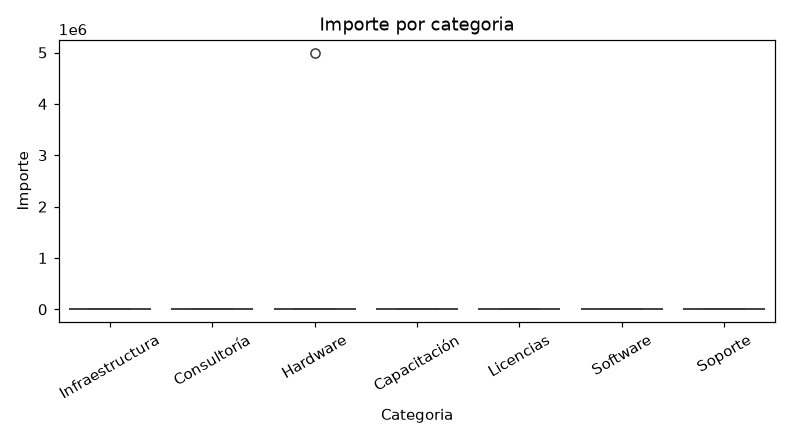
filas: 150 | importe no numerico o ausente: 6
filas que quedan: 144

limites por categoria:
                      q1       q3      iqr  limite_bajo  limite_alto
categoria
Capacitación      630.87  2550.98  1920.11     -2249.30      5431.14
Consultoría       598.66  3292.42  2693.76     -3441.98      7333.06
Hardware         1820.59  3646.36  1825.77      -918.07      6385.02
Infraestructura   843.08  3540.48  2697.40     -3203.01      7586.58
Licencias         820.03  3534.21  2714.18     -3251.23      7605.48
Software         1172.59  2466.50  1293.91      -768.28      4407.36
Soporte          1172.56  2463.09  1290.53      -763.24      4398.88

atipicos por categoria:
categoria
Hardware    1
Seis de 150 filas no traen un importe utilizable, y eso se informa antes de graficar, no después. Con las 144 que quedan, los límites de Tukey salen de los mismos cuartiles que dibuja la caja: Q1 − 1,5 · IQR y Q3 + 1,5 · IQR.
Fijate en los límites bajos: casi todos son negativos, y los importes no lo son. Eso significa que por abajo no puede haber atípicos en estas categorías: la regla de Tukey es simétrica y los datos no. Solo Hardware tiene un atípico, y por arriba.
1,5 veces el rango intercuartílico es una convención, no un diagnóstico. Un punto fuera del bigote puede ser un error de carga, un caso real y raro, o una observación que pertenece a otra población.
La caja te dice dónde mirar. Qué hacer con eso se decide con el dominio, igual que en la lección 8.6: es imposible y sale, es real y se muestra con y sin, o es de otro grupo y se separa.
Cuántas observaciones sostiene cada caja
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

soporte = pd.DataFrame({
    "turno": ["Manana"] * 30 + ["Tarde"] * 25 + ["Noche"] * 3,
    "minutos": [12, 15, 9, 22, 18, 11, 14, 25, 17, 13,
                16, 19, 10, 21, 14, 12, 18, 23, 15, 11,
                13, 20, 16, 9, 24, 17, 12, 19, 15, 14,
                20, 26, 18, 31, 22, 19, 24, 29, 21, 17,
                23, 27, 20, 33, 25, 18, 22, 30, 19, 24,
                26, 21, 28, 23, 20,
                15, 16, 17]})

conteo = soporte.groupby("turno")["minutos"].agg(["count", "median", "std"])
print("antes de graficar, cuantas observaciones sostiene cada caja:")
print(conteo.round(2).to_string())
print("\nNoche tiene 3 observaciones: su caja describe tres numeros, no un turno.")

fig, ax = plt.subplots()
orden = ["Manana", "Tarde", "Noche"]
sns.boxplot(data=soporte, x="turno", y="minutos", order=orden,
            hue="turno", hue_order=orden, legend=False, ax=ax)
sns.stripplot(data=soporte, x="turno", y="minutos", order=orden,
              color="black", alpha=0.45, size=4, ax=ax)
for i, t in enumerate(orden):
    ax.annotate("n = %d" % int(conteo.loc[t, "count"]),
                xy=(i, soporte["minutos"].max() + 1), ha="center", fontsize=9)
ax.set_title("Tiempo de atencion por turno")
ax.set_xlabel("Turno")
ax.set_ylabel("Minutos")
fig.tight_layout()
plt.show()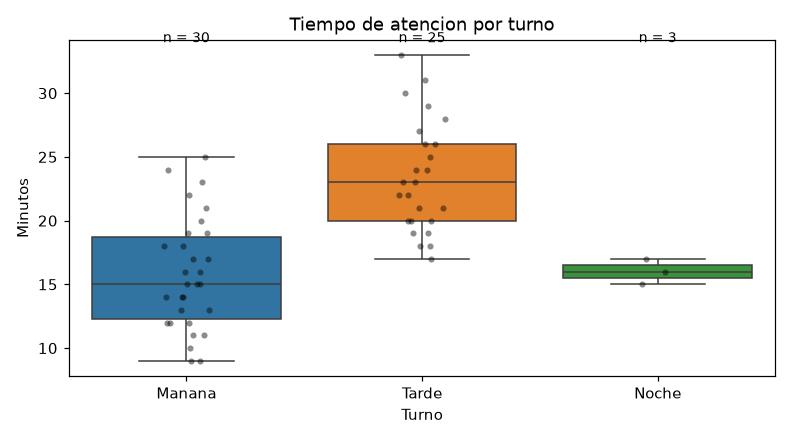
antes de graficar, cuantas observaciones sostiene cada caja:
        count  median   std
turno
Manana     30    15.0  4.41
Noche       3    16.0  1.00
Tarde      25    23.0  4.40

Noche tiene 3 observaciones: su caja describe tres numeros, no un turno.
Las tres cajas se dibujan igual de prolijas y una está hecha con
tres observaciones. No hay nada en el gráfico que lo diga: el ancho de
la caja no depende del n, así que el turno noche se lee como si fuera
comparable con los otros dos.
De ahí la regla práctica: imprimir el conteo por grupo antes de graficar, y anotarlo en la figura cuando los grupos sean desparejos. Es una línea de código y evita una conclusión sobre nada.
Acá hay que elegir
- Caja cuando hay varios grupos y lo que importa es comparar nivel y dispersión. Es la opción por defecto y la que todo el mundo sabe leer.
- Violín cuando sospechás que la forma importa: bimodalidad, asimetría fuerte, una cola larga. Necesita bastantes observaciones por grupo para no mentir.
- Solo puntos (
stripplotoswarmplot) cuando hay pocas observaciones. Con seis datos por grupo, un resumen de cinco números no resume nada: mostralos. - Caja más puntos, que es lo que hacen los ejemplos de esta lección, cuando querés las dos cosas y el volumen lo permite.
Con muchos miles de observaciones el stripplot se vuelve una mancha: ahí
conviene alpha bajo, una muestra, o quedarse con el violín.
Dónde se rompe
Causa: un valor fuera de dominio estira el eje. Es lo mismo que pasaba en la lección 9.1 con la nota de 99.
Arreglo: filtrar por el rango declarado antes de graficar e informarlo.
No usar set_ylim: el valor seguiría contaminando los cuartiles.
Causa: Q1 y Q3 coinciden. Pasa cuando el grupo tiene muy pocas observaciones o casi todas repiten el mismo valor.
Arreglo: mirá el conteo por grupo. Si son tres o cuatro datos, mostrá los puntos en vez de la caja.
Causa: la densidad estimada suaviza más allá de los datos observados. No es un dato: es la curva.
Arreglo: cut=0 corta la densidad en el mínimo y el máximo
reales. Y aclará en el texto que la panza es una estimación.
Causa: Seaborn los ordena por orden de aparición o alfabéticamente, y «Mañana, Noche, Tarde» casi nunca es lo que querés.
Arreglo: order=["Manana", "Tarde", "Noche"], y el mismo valor
en hue_order si estás usando hue.
Causa: demasiados puntos, opacos y grandes.
Arreglo: alpha=0.4 y size=4. Con miles de
observaciones, sacá el stripplot: ya no aporta.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
sns.boxplot(data=df, x="g", y="v") | Una caja por grupo | Comparar nivel y dispersión |
hue="g", legend=False | Colorea por grupo sin leyenda redundante | Cuando hue repite a x |
order=[...] | Fija el orden de las categorías | Casi siempre |
sns.stripplot(..., alpha=0.5, size=4) | Las observaciones encima | Hasta unos cientos de puntos |
sns.swarmplot(...) | Puntos sin superponer | Pocas observaciones, más legible |
sns.violinplot(..., inner="quart") | Densidad con los cuartiles adentro | Cuando la forma importa |
cut=0 | No extiende la densidad más allá de los datos | Variables acotadas |
df.groupby("g")["v"].describe() | Los cinco números y el conteo | Antes de graficar, siempre |
df.groupby("g")["v"].quantile(0.25) | Q1 por grupo | Calcular límites de Tukey |
q3 - q1 | Rango intercuartílico | La altura de la caja |
q1 - 1.5 * iqr, q3 + 1.5 * iqr | Los cortes de atípico | Contar y listar los que se escapan |
ax.tick_params(axis="x", rotation=30) | Gira las etiquetas | Categorías con nombres largos |