Indice / Visualizacion con Seaborn / 9.1
Seaborn sobre Matplotlib: data, x, y, hue
Seaborn no reemplaza a Matplotlib: se apoya en él. Entender eso ahorra la mitad de los problemas de esta unidad, y la otra mitad se evita poniendo la tabla en el formato que Seaborn espera.
Para qué sirve
La unidad anterior armó gráficos pieza por pieza: una figura, unos ejes, un bucle por grupo, una leyenda a mano. Funciona y hay que saber hacerlo, porque es lo que permite controlar cualquier detalle.
Pero la mayoría de los gráficos de análisis son los mismos cinco o seis, siempre sobre una tabla, casi siempre partidos por alguna categoría. Seaborn es una interfaz para esos casos: se le pasa el DataFrame entero y los nombres de las columnas, y él recorre, agrupa, colorea y rotula.
El ejemplo mínimo
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

estudio = pd.DataFrame({
    "horas": [2, 3, 4, 5, 5, 6, 7, 8, 9, 10, 11, 12],
    "nota": [52, 55, 60, 62, 68, 70, 74, 78, 83, 85, 89, 92],
    "curso": ["Datos", "Software", "IA"] * 4})

print("filas por curso:")
print(estudio["curso"].value_counts().sort_index().to_string())
print("\nnota media por curso:")
print(estudio.groupby("curso")["nota"].mean().round(2).to_string())

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4), sharey=True)

# A mano: un scatter por grupo, y la leyenda sale de los label de cada uno.
for nombre, grupo in estudio.groupby("curso"):
    axes[0].scatter(grupo["horas"], grupo["nota"], label=nombre, s=55, alpha=0.8)
axes[0].legend(title="curso")
axes[0].set_title("Matplotlib: un scatter por grupo")
axes[0].set_xlabel("Horas por semana")
axes[0].set_ylabel("Nota final")

# Con Seaborn: una llamada. hue recorre la columna y arma la leyenda.
sns.scatterplot(data=estudio, x="horas", y="nota", hue="curso",
                s=55, alpha=0.8, ax=axes[1])
axes[1].set_title("Seaborn: hue hace el recorrido")
axes[1].set_xlabel("Horas por semana")

fig.tight_layout()
plt.show()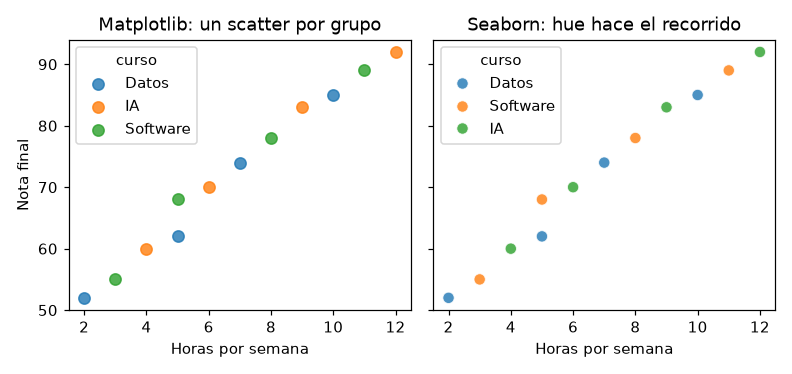
filas por curso:
curso
Datos       4
IA          4
Software    4

nota media por curso:
curso
Datos       68.25
IA          76.25
Software    72.50
Los dos paneles dicen exactamente lo mismo. A la izquierda hay un bucle, un
label por grupo y una llamada a legend(). A la derecha hay una
línea con hue="curso". La diferencia no es estética: es que el color dejó de
ser algo que se asigna y pasó a ser una columna de la tabla.
La idea: el color es una columna, no una decisión
La intuición que hay que corregir de entrada es «Seaborn es otra biblioteca de
gráficos». No lo es. Cada función de Seaborn dibuja sobre unos Axes de
Matplotlib y devuelve esos mismos Axes.
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

estudio = pd.DataFrame({
    "horas": [2, 3, 4, 5, 5, 6, 7, 8, 9, 10, 11, 12],
    "nota": [52, 55, 60, 62, 68, 70, 74, 78, 83, 85, 89, 92]})

print("horas:", list(estudio["horas"]))
print("nota :", list(estudio["nota"]))
print("correlacion:", round(estudio["horas"].corr(estudio["nota"]), 4))

sns.set_theme(style="whitegrid")

fig, ax = plt.subplots()
devuelto = sns.scatterplot(data=estudio, x="horas", y="nota", s=60, ax=ax)
print("\nlo que devuelve scatterplot:", type(devuelto).__name__)
print("es el mismo Axes que le pasamos:", devuelto is ax)

ax.set_title("Horas de estudio y nota final")
ax.set_xlabel("Horas por semana")
ax.set_ylabel("Nota sobre 100")
fig.tight_layout()
plt.show()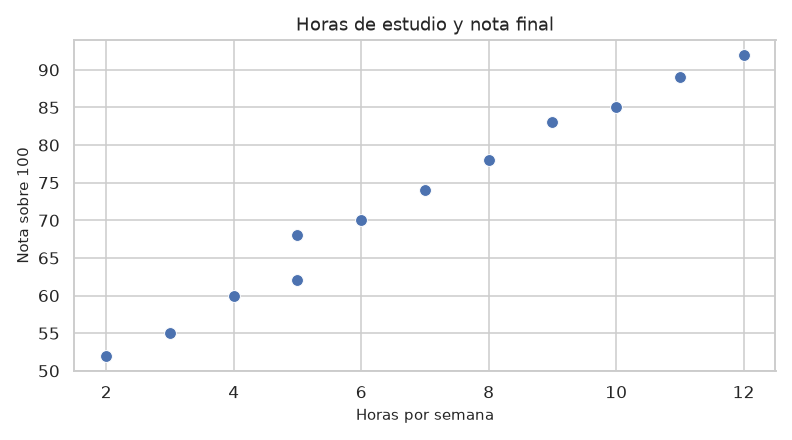
horas: [2, 3, 4, 5, 5, 6, 7, 8, 9, 10, 11, 12]
nota : [52, 55, 60, 62, 68, 70, 74, 78, 83, 85, 89, 92]
correlacion: 0.9924

lo que devuelve scatterplot: Axes
es el mismo Axes que le pasamos: True
Por eso todo lo de la unidad 8 sigue valiendo tal cual: ax.set_title,
ax.set_xlabel, ax.axhline, fig.tight_layout,
fig.savefig. Seaborn pone los datos en el lienzo; el lienzo sigue siendo de
Matplotlib.
Las axes-level (scatterplot, boxplot,
lineplot, heatmap, histplot, barplot,
violinplot, countplot, regplot) aceptan
ax= y dibujan donde les digas. Son las que se combinan en un panel.
Las figure-level (pairplot, relplot,
catplot, displot) crean su propia figura y no aceptan
ax=. Devuelven un objeto con un atributo .figure. Se usan solas,
nunca dentro de un panel armado a mano. En la lección 9.4 aparecen las dos.
Sobre datos de verdad
Hay un requisito que Seaborn no negocia y que es la causa número uno de frustración: la tabla tiene que estar en formato largo. Una fila por observación, y las variables en columnas.
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns

ancho = pd.read_csv("estudiantes_notas.csv")
print("formato ancho: una fila por estudiante, una columna por evaluacion")
print(ancho.head(3).to_string(index=False))
print("columnas:", list(ancho.columns))

largo = ancho.melt(id_vars=["legajo", "estudiante"],
                   value_vars=["nota_1", "nota_2", "nota_3"],
                   var_name="evaluacion", value_name="nota")
print("\nformato largo: una fila por estudiante y evaluacion")
print(largo.head(3).to_string(index=False))
print("filas:", len(ancho), "->", len(largo))

# nota_3 viene como texto porque trae guiones, y hay notas fuera del 0 a 10.
# La politica se declara antes de graficar: lo que no es nota, no entra.
numero = pd.to_numeric(largo["nota"], errors="coerce")
en_rango = numero.between(0, 10)
print("\nvalores no numericos:", int(numero.isna().sum()))
print("fuera del rango 0 a 10:", int((numero.notna() & ~en_rango).sum()),
      "->", sorted(float(v) for v in numero[numero.notna() & ~en_rango].unique()))

valido = largo.assign(nota=numero)[en_rango]
print("filas que quedan:", len(valido), "de", len(largo))
print("\nmediana por evaluacion:")
print(valido.groupby("evaluacion")["nota"].median().round(2).to_string())

fig, ax = plt.subplots()
sns.boxplot(data=valido, x="evaluacion", y="nota",
            hue="evaluacion", legend=False, ax=ax)
ax.set_title("Notas por evaluacion, sin los valores imposibles")
ax.set_xlabel("Evaluacion")
ax.set_ylabel("Nota sobre 10")
fig.tight_layout()
plt.show()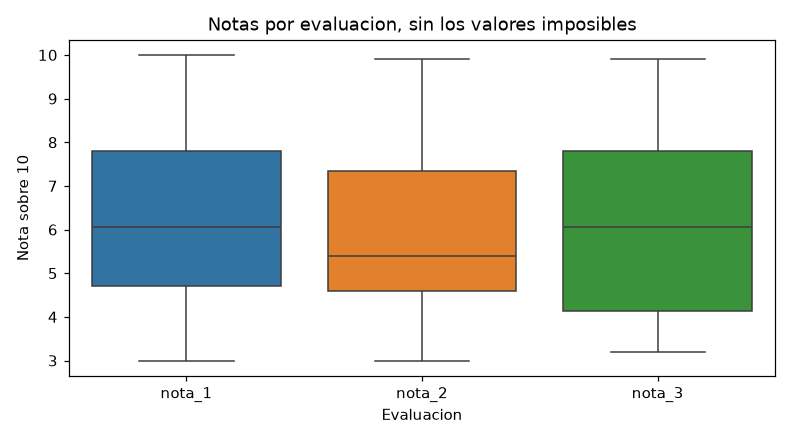
formato ancho: una fila por estudiante, una columna por evaluacion
legajo     estudiante  nota_1  nota_2 nota_3
 L2601  Karina Acosta     9.7     4.7    8.6
 L2602 Santiago Ramos     6.0     3.8    4.2
 L2603     Carla Luna     8.1     3.6    3.8
columnas: ['legajo', 'estudiante', 'nota_1', 'nota_2', 'nota_3']

formato largo: una fila por estudiante y evaluacion
legajo     estudiante evaluacion nota
 L2601  Karina Acosta     nota_1  9.7
 L2602 Santiago Ramos     nota_1  6.0
 L2603     Carla Luna     nota_1  8.1
filas: 40 -> 120

valores no numericos: 5
fuera del rango 0 a 10: 4 -> [-1.0, 10.5, 12.5, 99.0]
filas que quedan: 111 de 120

mediana por evaluacion:
evaluacion
nota_1    6.05
nota_2    5.40
nota_3    6.05
El archivo viene en formato ancho: una fila por estudiante y una
columna por evaluación. Es cómodo para leerlo con los ojos y es inservible para
hue, porque «evaluación» no existe como columna: está repartida en los
nombres de tres columnas. melt la crea: 40 filas se convierten en 120, y
recién ahí se puede pedir x="evaluacion".
Y aparece lo de siempre. nota_3 se lee como texto porque trae guiones, y
hay notas de 99, de 12,5 y de −1 en una escala de 0 a 10. Nueve de las 120 filas no son
notas. La política se declara antes de graficar, no después de ver que
el gráfico quedó raro.
Acá hay que elegir
No es una competencia y el criterio es bastante nítido:
- Seaborn cuando el gráfico es uno de los estándar sobre una tabla ordenada, sobre todo si hay que partir por una categoría o si el gráfico calcula algo (una regresión, una densidad, una matriz de correlación).
- Matplotlib cuando el gráfico es a medida, cuando hay que componer un panel con piezas distintas, o cuando hace falta control fino de un elemento puntual.
- Los dos, que es el caso normal: Seaborn dibuja y Matplotlib rotula, anota y guarda.
Lo que no conviene es usar Seaborn para evitar aprender Matplotlib. Cuando el gráfico no salga como esperabas, el que arregla es el de abajo.
Dónde se rompe
Causa: esa columna no existe en el DataFrame que pasaste. Casi siempre es formato ancho: la variable está en los nombres de las columnas, no en una columna.
Arreglo: melt primero. Y revisá el nombre exacto con
list(df.columns): un acento o una mayúscula de más dan el mismo error.
Causa: la columna que creés numérica es de tipo object porque
trae algún token de texto (-, N/A, vacío).
Arreglo: pd.to_numeric(col, errors="coerce") y decidir qué
hacer con lo que quedó en NaN. Informá cuántas filas fueron.
Causa: un valor fuera de dominio. Una nota de 99 en una escala de 0 a 10 estira el eje y aplasta todo lo demás.
Arreglo: filtrar por rango declarado antes de graficar, e informar qué quedó afuera. No recortar el eje: eso esconde el problema en vez de resolverlo.
Causa: estás tratando una función figure-level como si devolviera
Axes. pairplot devuelve un PairGrid.
Arreglo: usá g.figure.suptitle(...). Y si necesitabas meterlo en
un panel, la función figure-level no es la indicada.
Causa: pasaste hue con la misma columna que x en un
boxplot o un barplot. Es lo que pide Seaborn para colorear por
categoría, pero la leyenda no aporta nada.
Arreglo: legend=False, como en los ejemplos de esta unidad.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
import seaborn as sns | El alias de siempre | Siempre |
sns.scatterplot(data=df, x="a", y="b") | Nube de puntos | Dos variables continuas |
..., hue="grupo" | Un color por categoría, con leyenda | Partir por una categoría |
..., ax=ax | Dibuja en esos Axes | Funciones axes-level, paneles |
df.melt(id_vars=[...], value_vars=[...]) | De ancho a largo | Antes de casi cualquier gráfico |
var_name=, value_name= | Nombra las dos columnas nuevas | Siempre, o quedan var/value |
pd.to_numeric(col, errors="coerce") | Texto a número, lo que no se puede queda NaN | Columna object que debería ser número |
col.between(0, 10) | Máscara de rango | Filtrar valores imposibles |
sns.barplot(data=df, x="cat", y="v") | Barras con la media por categoría | Comparar categorías |
ax.bar_label(ax.containers[0], fmt="%.0f") | Escribe el valor sobre cada barra | Cuando el número exacto importa |
sns.set_theme(style="whitegrid") | Estilo global de la figura | Una vez, al principio del script |