Indice / Visualizacion con Matplotlib / 8.5
Histograma: la forma de una variable
Un promedio dice dónde está el centro y no dice nada de si hay uno solo. El histograma es el gráfico que contesta la pregunta que el promedio esconde.
Para qué sirve
Dos cursos con promedio 6 pueden ser cosas muy distintas: uno con todos alrededor del 6, y otro con la mitad en 3 y la mitad en 9. La media es idéntica y la conclusión pedagógica es opuesta. La única forma barata de distinguirlos es mirar la forma.
El histograma corta el rango en intervalos contiguos y cuenta cuántas observaciones caen en cada uno. Contesta tres cosas de una vez: dónde se concentra, qué tan simétrico es, y si hay valores lejos del grupo.
ELI5Explicado facil
Imaginate que ponés a los alumnos en fila por nota, y después los agrupás: los que sacaron entre 0 y 1 en un montón, entre 1 y 2 en otro, y así.
El histograma es la foto de esos montones vistos de costado. Un montón grande en el medio quiere decir que casi todos sacaron algo parecido. Dos montones separados quieren decir que hay dos grupos distintos, y eso es una noticia que el promedio nunca te habría dado.
En las barras hay categorías separadas, y por eso las barras están separadas: no hay nada entre «Norte» y «Sur». En un histograma los intervalos son contiguos, y por eso las barras se tocan: entre 20 y 25 minutos hay 21, 22 y todo lo demás.
Si están pegadas, el eje horizontal es una escala. Si están separadas, es una lista de nombres.
El ejemplo mínimo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

entregas = pd.DataFrame({"minutos": [18, 20, 21, 22, 23, 24, 24, 25, 25, 26,
                                     27, 28, 29, 30, 31, 32, 33, 35, 39, 47]})

media = entregas["minutos"].mean()

# Los bordes se declaran a mano: de 15 a 50 cada 5 minutos. Con bins=7 el
# resultado se parece, pero los cortes caen en numeros que no significan nada
# y el grafico deja de poder describirse con palabras.
bordes = np.arange(15, 55, 5)

fig, ax = plt.subplots()
ax.hist(entregas["minutos"], bins=bordes, color="teal", edgecolor="white")
ax.axvline(media, color="red", linestyle="--",
           label=f"Media = {media:.1f} min")
ax.set_title("La mitad de los pedidos sale entre 20 y 30 minutos")
ax.set_xlabel("Minutos de preparacion")
ax.set_ylabel("Cantidad de pedidos")
ax.set_xticks(bordes)
ax.legend()
fig.tight_layout()
plt.show()

conteo, _ = np.histogram(entregas["minutos"], bins=bordes)
for desde, cantidad in zip(bordes[:-1], conteo):
    print(f"  {desde:>2} a {desde + 5:>2} min: {cantidad}")
print()
print("media:", round(media, 2), " mediana:", entregas["minutos"].median())
print("La media es mayor que la mediana: la cola de la derecha la empuja.")
print("Los dos pedidos de 39 y 47 minutos no son errores; son los que hay")
print("que mirar.")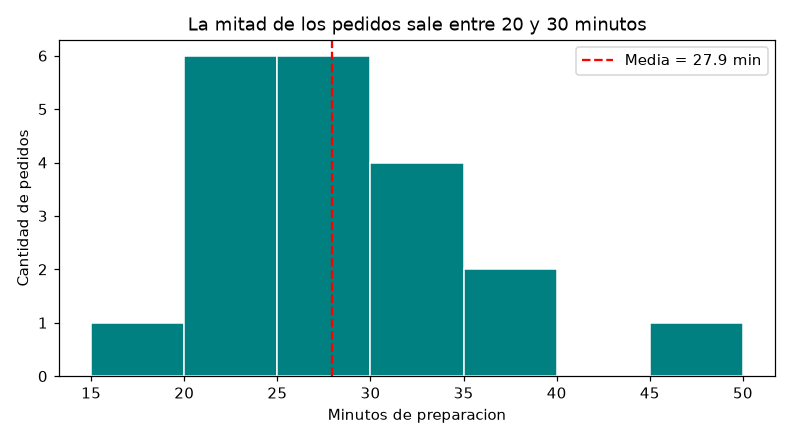
  15 a 20 min: 1
  20 a 25 min: 6
  25 a 30 min: 6
  30 a 35 min: 4
  35 a 40 min: 2
  40 a 45 min: 0
  45 a 50 min: 1

media: 27.95  mediana: 26.5
La media es mayor que la mediana: la cola de la derecha la empuja.
Los dos pedidos de 39 y 47 minutos no son errores; son los que hay
que mirar.
La media (27,95) es mayor que la mediana (26,5). Eso no es un detalle estadístico: es la firma de una cola hacia la derecha, y se ve en el gráfico como dos pedidos sueltos allá lejos. Cuando la media y la mediana se separan, la distribución no es simétrica y hay que decir cuál de las dos se está usando.
Sobre datos de verdad
Un valor imposible y el histograma se apaga
import pandas as pd
import matplotlib.pyplot as plt

notas = pd.read_csv("estudiantes_notas.csv")
segunda = pd.to_numeric(notas["nota_2"], errors="coerce")

fig, ax = plt.subplots()
ax.hist(segunda, bins=10, edgecolor="white")
ax.set_title("Distribucion de la nota 2")
ax.set_xlabel("Nota")
ax.set_ylabel("Alumnos")
fig.tight_layout()
plt.show()

print("cantidad de notas:", int(segunda.notna().sum()))
print("minimo:", segunda.min(), " maximo:", segunda.max())
print("media:", round(segunda.mean(), 2),
      " mediana:", segunda.median())
print()
print("notas fuera del rango 0 a 10:")
print(notas.loc[segunda > 10, ["legajo", "estudiante", "nota_2"]]
      .to_string(index=False))
print()
print("bins=10 reparte el rango observado en diez intervalos iguales. Con un")
print("maximo de 99, cada intervalo mide casi diez puntos, asi que las 39")
print("notas reales caen todas en el primero.")
print("La media tampoco sirve:", round(segunda.mean(), 2),
      "con el 99 y", round(segunda[segunda <= 10].mean(), 2), "sin el.")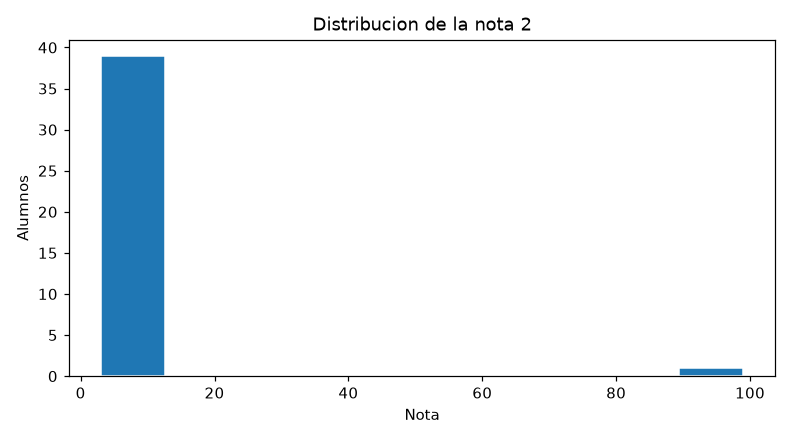
cantidad de notas: 40
minimo: 3.0  maximo: 99.0
media: 8.17  mediana: 5.45

notas fuera del rango 0 a 10:
legajo      estudiante  nota_2
 L2626 Lautaro Cabrera    99.0

bins=10 reparte el rango observado en diez intervalos iguales. Con un
maximo de 99, cada intervalo mide casi diez puntos, asi que las 39
notas reales caen todas en el primero.
La media tampoco sirve: 8.17 con el 99 y 5.84 sin el.
El eje horizontal llega a 99 porque hay una nota de 99. Con bins=10,
Matplotlib reparte el rango observado en diez intervalos iguales, así que cada
intervalo mide casi diez puntos y las 39 notas reales caen todas en el primero.
El gráfico tiene una sola barra y no dice absolutamente nada.
La media cuenta la misma historia: 8,17 con el 99 adentro y 5,84 sin él. Un solo valor sobre cuarenta mueve el promedio de la clase dos puntos y medio.
Cuántos intervalos
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

notas = pd.read_csv("estudiantes_notas.csv")
segunda = pd.to_numeric(notas["nota_2"], errors="coerce")

# La nota vive en 0 a 10 por definicion del dominio, no porque lo diga el
# archivo. Lo que queda afuera se descarta y se informa.
valida = segunda[segunda.between(0, 10)]
print("descartadas:", int(segunda.notna().sum() - len(valida)))

fig, axes = plt.subplots(1, 3, figsize=(7.2, 3.0), sharey=True)
for eje, cantidad in zip(axes, [4, 10, 25]):
    eje.hist(valida, bins=np.linspace(0, 10, cantidad + 1),
             color="teal", edgecolor="white")
    eje.set_title(f"{cantidad} intervalos")
    eje.set_xlabel("Nota")
axes[0].set_ylabel("Alumnos")
fig.suptitle("Los mismos 39 alumnos")
fig.tight_layout()
plt.show()

print()
for cantidad in [4, 10, 25]:
    conteo, bordes = np.histogram(valida, bins=np.linspace(0, 10, cantidad + 1))
    print(f"{cantidad:>2} intervalos, ancho {bordes[1] - bordes[0]:.1f}:",
          conteo.tolist())
print()
print("Con 4 intervalos quedan dos barras iguales de 15 y no se puede")
print("decir si la clase se concentra abajo o arriba del 5.")
print("Con 25 casi todos los intervalos tienen cero o un alumno: eso es ruido,")
print("porque hay 39 datos y no alcanzan para 25 tramos.")
print("La cantidad de intervalos es una decision y se declara.")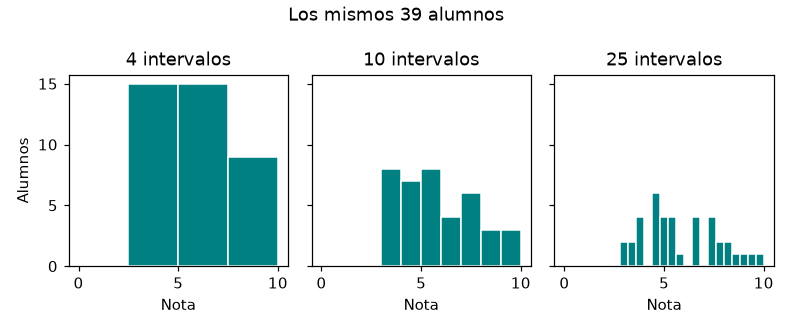
descartadas: 1

 4 intervalos, ancho 2.5: [0, 15, 15, 9]
10 intervalos, ancho 1.0: [0, 0, 0, 8, 7, 8, 4, 6, 3, 3]
25 intervalos, ancho 0.4: [0, 0, 0, 0, 0, 0, 0, 2, 2, 4, 0, 6, 4, 4, 1, 0, 4, 0, 4, 2, 2, 1, 1, 1, 1]

Con 4 intervalos quedan dos barras iguales de 15 y no se puede
decir si la clase se concentra abajo o arriba del 5.
Con 25 casi todos los intervalos tienen cero o un alumno: eso es ruido,
porque hay 39 datos y no alcanzan para 25 tramos.
La cantidad de intervalos es una decision y se declara.
Con cuatro intervalos quedan dos barras iguales de 15 alumnos: no se puede decir si la clase se concentra por debajo o por encima del 5. Con veinticinco, casi todos los intervalos tienen cero o un alumno, y lo que se ve es el azar de dónde cayó cada nota. Con diez se ve una distribución con centro entre 4 y 7 y una cola corta hacia arriba, que es lo que hay.
Comparar tres distribuciones
import pandas as pd
import matplotlib.pyplot as plt

notas = pd.read_csv("estudiantes_notas.csv")
columnas = ["nota_1", "nota_2", "nota_3"]

limpias = {}
for columna in columnas:
    valor = pd.to_numeric(notas[columna], errors="coerce")
    limpias[columna] = valor[valor.between(0, 10)]
    print(f"{columna}: {len(limpias[columna])} validas de {len(notas)}")

colores = ["lightblue", "lightgreen", "lightsalmon"]

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4))

cajas = axes[0].boxplot([limpias[c] for c in columnas],
                        tick_labels=columnas, patch_artist=True)
for caja, color in zip(cajas["boxes"], colores):
    caja.set_facecolor(color)
axes[0].set_title("Cajas")
axes[0].set_ylabel("Nota")

for columna, color in zip(columnas, colores):
    axes[1].hist(limpias[columna], bins=10, range=(0, 10), alpha=0.5,
                 color=color, label=columna)
axes[1].set_title("Histogramas superpuestos")
axes[1].set_xlabel("Nota")
axes[1].set_ylabel("Alumnos")
axes[1].legend()

fig.tight_layout()
plt.show()

print()
resumen = pd.DataFrame({
    "n": {c: len(limpias[c]) for c in columnas},
    "media": {c: round(limpias[c].mean(), 2) for c in columnas},
    "mediana": {c: limpias[c].median() for c in columnas},
    "desvio": {c: round(limpias[c].std(), 2) for c in columnas},
})
print(resumen.to_string())
print()
print("La caja resume: mediana, mitad central y extremos. Sirve para comparar")
print("tres grupos de un vistazo y esconde si hay dos grupos separados.")
print("El histograma muestra la forma y con tres superpuestos ya cuesta leer.")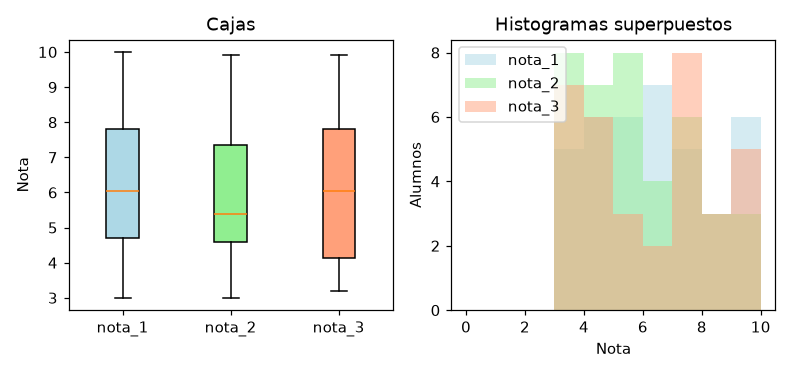
nota_1: 38 validas de 40
nota_2: 39 validas de 40
nota_3: 34 validas de 40

         n  media  mediana  desvio
nota_1  38   6.33     6.05    1.97
nota_2  39   5.84     5.40    1.91
nota_3  34   6.23     6.05    2.18

La caja resume: mediana, mitad central y extremos. Sirve para comparar
tres grupos de un vistazo y esconde si hay dos grupos separados.
El histograma muestra la forma y con tres superpuestos ya cuesta leer.
Las cajas comparan bien y esconden la forma: una caja no distingue un grupo
compacto de dos grupos separados con la misma mediana. Los histogramas superpuestos
muestran la forma y con tres ya cuesta leer. Con más de tres grupos, la salida
habitual es un histograma por eje con sharex=True y
sharey=True, que es lo único que hace comparables las alturas.
Acá hay que elegir
La forma del histograma depende de la cantidad de intervalos, y no existe la cantidad correcta. Existen tres cosas útiles:
- Probar varias. Si la forma sobrevive a 8, 12 y 20 intervalos, es real. Si el segundo pico aparece solo con 25, era ruido.
- Elegir cortes que signifiquen algo. De 15 a 50 cada 5 minutos se puede describir con palabras. Cortes en 17,3 y 23,8 no.
- Declararla. «Intervalos de 5 minutos» en el eje o en el pie. Sin eso, el lector no puede saber si la forma es del dato o de la elección.
Dónde se rompe
Causa: un valor extremo estira el rango, y los intervalos automáticos se calculan sobre ese rango.
Arreglo: validar el dominio antes (between(0, 10) para una
nota) o fijar los bordes con range=(0, 10). Lo primero es mejor:
range esconde el valor imposible en vez de reportarlo.
Causa: los bordes automáticos no coinciden con los cortes naturales del dato, y un montón de valores repetidos cae justo en un borde.
Arreglo: bordes explícitos con np.arange. Ojo con el último:
np.arange(15, 50, 5) llega hasta 45, así que el 47 queda afuera.
Causa: hist descarta lo que cae fuera de range,
y descarta los NaN, sin avisar en ninguno de los dos casos.
Arreglo: imprimir siempre len(serie) y
serie.notna().sum(). Que el total del histograma coincida con el
total de la tabla es una comprobación de treinta segundos.
Causa: cada uno calculó sus propios bordes, así que las barras no están alineadas y las alturas cuentan cosas distintas.
Arreglo: los mismos bordes para los dos: bins=10,
range=(0, 10) en las dos llamadas, o un array de bordes compartido.
Causa: se comparan conteos. Un grupo de 400 tiene barras más altas que uno de 40 aunque la forma sea idéntica.
Arreglo: density=True, que normaliza el área a 1. El eje
vertical deja de ser «cantidad» y hay que cambiar el rótulo.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
ax.hist(v, bins=12) | Doce intervalos sobre el rango observado | Primera mirada |
ax.hist(v, bins=np.arange(15, 55, 5)) | Bordes explícitos | Cuando los cortes tienen que significar algo |
ax.hist(v, range=(0, 10)) | Fija el rango del eje | Dominio conocido; recorta en silencio |
ax.hist(v, density=True) | Normaliza el área a 1 | Comparar grupos de tamaños distintos |
ax.hist(a, alpha=0.5) dos veces | Superpuestos | Dos o tres grupos, mismos bordes |
ax.axvline(media, linestyle="--") | Marca la media | Referencia visual |
ax.boxplot([a, b, c]) | Cajas comparadas | Muchos grupos; esconde la forma |
np.histogram(v, bins=bordes) | Los conteos, sin dibujar | Para imprimir y verificar |
serie.between(0, 10) | Máscara de dominio | Antes del histograma, siempre |
serie.describe() | Centro, dispersión y extremos | Junto al gráfico, no en vez de |
plt.subplots(1, 3, sharey=True) | Alturas comparables | Varios histogramas |