Indice / Visualizacion con Matplotlib / 8.4
Barras: comparar categorías
Es el gráfico más fácil de dibujar y el más fácil de usar para mentir. Las dos cosas por el mismo motivo: la longitud se lee muy bien, así que quien decide dónde empieza a medirse decide qué se entiende.
Para qué sirve
La pregunta es «¿qué categoría tiene más?». La barra la contesta con una longitud apoyada en una base común, que es la segunda codificación mejor leída que existe. Por eso una comparación entre cinco sucursales se entiende sin pensar y la misma comparación en una tabla exige leer cinco números y restarlos mentalmente.
Lo que la barra no contesta es cómo se reparte lo que hay adentro. Una sucursal que suma 148.000 pesos puede tener cuarenta transacciones medianas o cuatro enormes, y la barra es idéntica en los dos casos. Esa es la pregunta de la lección 8.5.
El ejemplo mínimo
import pandas as pd
import matplotlib.pyplot as plt

medios = pd.DataFrame({"medio": ["Colectivo", "Subte", "Bicicleta", "Auto", "A pie"],
                       "cantidad": [120, 95, 48, 62, 75]})
medios = medios.sort_values("cantidad", ascending=False)

# Un color para todo y el acento en el hallazgo. Darle un color distinto a cada
# barra es habitual y no agrega nada: la categoria ya esta escrita abajo, asi
# que el color estaria codificando por segunda vez lo mismo.
colores = ["darkorange" if i == 0 else "steelblue"
           for i in range(len(medios))]

fig, ax = plt.subplots()
barras = ax.bar(medios["medio"], medios["cantidad"], color=colores)
ax.bar_label(barras, padding=3)
ax.set_title("El colectivo es el medio mas usado")
ax.set_xlabel("Medio de transporte")
ax.set_ylabel("Estudiantes")
ax.set_ylim(0, 135)
fig.tight_layout()
plt.show()

print(medios.to_string(index=False))
print()
primero, segundo = medios["cantidad"].iloc[0], medios["cantidad"].iloc[1]
print("diferencia entre el primero y el segundo:", primero - segundo)
print("el primero sobre el total:",
      round(primero / medios["cantidad"].sum() * 100, 1), "%")
print()
print("El titulo dice el hallazgo, no el tema. 'Medio de transporte' habria")
print("obligado a leer el grafico para saber que dice.")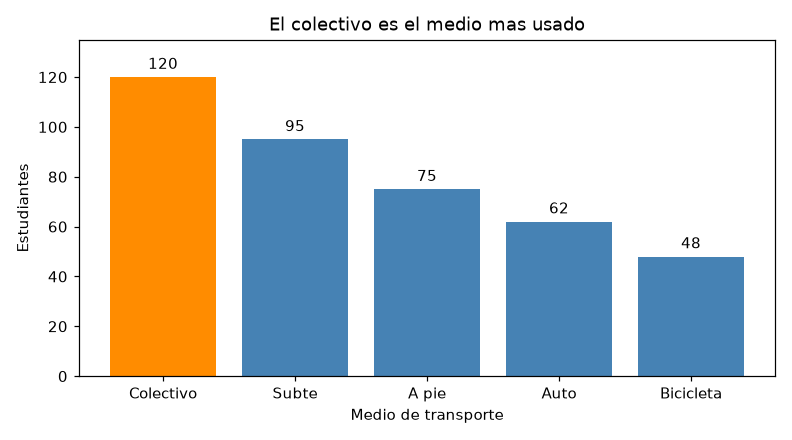
    medio  cantidad
Colectivo       120
    Subte        95
    A pie        75
     Auto        62
Bicicleta        48

diferencia entre el primero y el segundo: 25
el primero sobre el total: 30.0 %

El titulo dice el hallazgo, no el tema. 'Medio de transporte' habria
obligado a leer el grafico para saber que dice.Ordenar por valor. El orden alfabético es un orden que no le importa a nadie. Ordenar de mayor a menor convierte el gráfico en un ranking legible de un vistazo. La excepción son las categorías que ya tienen orden propio (lunes a domingo, tramos de edad): ahí el orden natural gana.
El título dice el hallazgo. «Medio de transporte» obliga a leer el gráfico para saber qué dice. «El colectivo es el medio más usado» ya lo dijo, y el gráfico pasa a ser la prueba en vez del acertijo.
Sobre datos de verdad
Una sola fila imposible
import pandas as pd
import matplotlib.pyplot as plt

tx = pd.read_csv("transacciones_sucursales.csv")
tx["importe"] = pd.to_numeric(tx["importe"], errors="coerce")

# Sin mirar nada: se agrupa y se grafica. Es lo que sale primero, y corre.
total = tx.groupby("sucursal")["importe"].sum().sort_values()

fig, ax = plt.subplots()
ax.bar(total.index, total.to_numpy())
ax.set_title("Importe total por sucursal")
ax.set_xlabel("Sucursal")
ax.set_ylabel("Importe total")
fig.tight_layout()
plt.show()

print(total.round(2).to_string())
print()
print("Sur suma", round(total.max() / total.drop("Sur").sum(), 1),
      "veces lo que suman las otras cuatro juntas.")
print()
print("De donde sale:")
print(tx.nlargest(3, "importe")[["id", "sucursal", "tipo", "importe"]]
      .to_string(index=False))
print()
print("Una sola fila de ocho digitos. El grafico no esta mal dibujado: esta")
print("dibujando bien un dato que no puede ser cierto.")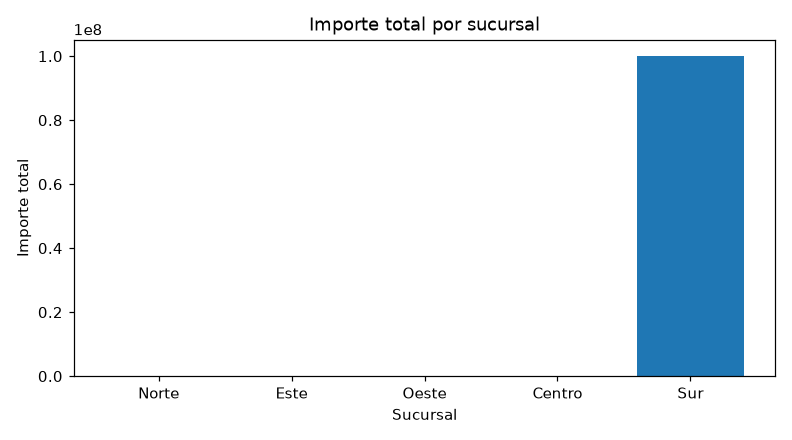
sucursal
Norte     1.018894e+05
Este      1.248336e+05
Oeste     1.337894e+05
Centro    1.344753e+05
Sur       1.001482e+08

Sur suma 202.3 veces lo que suman las otras cuatro juntas.

De donde sale:
    id sucursal    tipo     importe
TX0188      Sur Ingreso 99999999.99
TX0046     Este   Gasto     6428.97
TX0023    Oeste   Gasto     6386.45

Una sola fila de ocho digitos. El grafico no esta mal dibujado: esta
dibujando bien un dato que no puede ser cierto.
El gráfico está perfectamente dibujado. La escala llega a cien millones porque hay
una transacción de 99999999.99, y con esa escala las otras cuatro
sucursales miden menos de un píxel. Ningún ajuste de Matplotlib arregla
esto: el problema entró con los datos y se resuelve antes de dibujar.
Después de sacar lo imposible
import pandas as pd
import matplotlib.pyplot as plt

tx = pd.read_csv("transacciones_sucursales.csv")
importe = pd.to_numeric(tx["importe"], errors="coerce")

# Politica declarada: un importe negativo o de mas de cien mil no puede ser una
# transaccion de este negocio. Se descarta y se informa cuantas.
valido = importe.between(0, 100000)
print("filas descartadas:", int((~valido).sum()), "de", len(tx))
print("  ausentes:", int(importe.isna().sum()))
print("  negativas:", int((importe < 0).sum()))
print("  fuera de escala:", int((importe > 100000).sum()))

total = (tx.assign(importe=importe)[valido]
         .groupby("sucursal")["importe"].sum().sort_values())

fig, ax = plt.subplots()
barras = ax.barh(total.index, total.to_numpy(), color="steelblue")
ax.bar_label(barras, fmt="%.0f", padding=3)
ax.set_title("Sur y Norte se llevan 47 mil pesos de diferencia")
ax.set_xlabel("Importe total")
ax.set_xlim(0, 175000)
fig.tight_layout()
plt.show()

print()
print(total.round(2).to_string())
print()
print("diferencia entre la mayor y la menor:",
      round(total.max() - total.min(), 2))
print("la mayor sobre la menor:", round(total.max() / total.min(), 2))
print()
print("Ahora si se pueden comparar. Y notar que la diferencia real es del 46 %,")
print("no del 99 % que sugeria el grafico anterior.")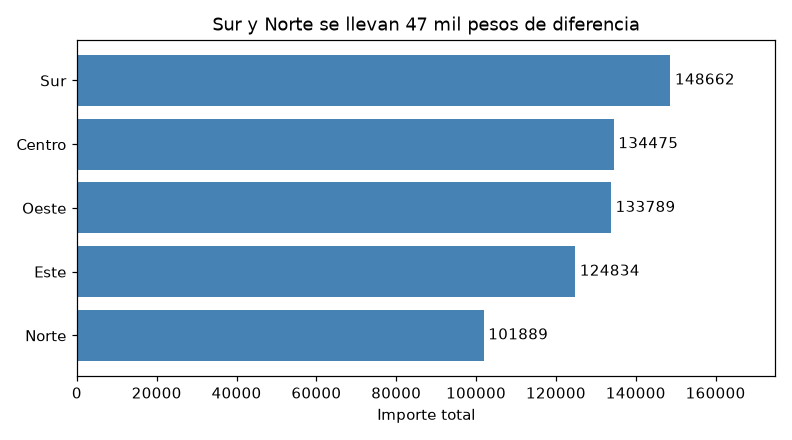
filas descartadas: 4 de 200
  ausentes: 2
  negativas: 1
  fuera de escala: 1

sucursal
Norte     101889.41
Este      124833.64
Oeste     133789.43
Centro    134475.27
Sur       148662.45

diferencia entre la mayor y la menor: 46773.04
la mayor sobre la menor: 1.46

Ahora si se pueden comparar. Y notar que la diferencia real es del 46 %,
no del 99 % que sugeria el grafico anterior.
Cuatro filas afuera de doscientas, y la conclusión cambia por completo: no hay una sucursal que se lleve todo, hay un 46 % de diferencia entre la mayor y la menor. La política es la misma que en la unidad 5, y acá se ve por qué importa tanto: el gráfico amplifica el defecto en vez de disimularlo.
«Se descartaron 4 de 200 transacciones: 2 con importe ausente, 1 negativa y 1 de ocho dígitos» es una frase que se puede defender en una mesa. Sin ella, alguien va a sumar la columna en una planilla, le va a dar cien millones y va a tener razón en desconfiar del gráfico.
Dónde empieza el eje
import pandas as pd
import matplotlib.pyplot as plt

tx = pd.read_csv("transacciones_sucursales.csv")
importe = pd.to_numeric(tx["importe"], errors="coerce")
total = (tx.assign(importe=importe)[importe.between(0, 100000)]
         .groupby("sucursal")["importe"].sum().sort_values())

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4), sharex=True)

axes[0].bar(total.index, total.to_numpy(), color="steelblue")
axes[0].set_ylim(0, 160000)
axes[0].set_title("Eje desde cero")
axes[0].set_ylabel("Importe total")

axes[1].bar(total.index, total.to_numpy(), color="indianred")
axes[1].set_ylim(90000, 160000)
axes[1].set_title("Eje desde 90.000")

for eje in axes:
    eje.tick_params(axis="x", labelrotation=45)
fig.suptitle("Los mismos cinco numeros")
fig.tight_layout()
plt.show()

print(total.round(2).to_string())
print()
print("Relacion real entre la mayor y la menor:",
      round(total.max() / total.min(), 2), "veces")
print("Relacion aparente en el grafico truncado:",
      round((total.max() - 90000) / (total.min() - 90000), 2), "veces")
print()
print("Las dos barras miden lo mismo. La de la derecha empieza a contar desde")
print("90.000, asi que la longitud dejo de ser proporcional al valor.")
print("Truncar el eje de unas barras no es un estilo: cambia lo que dicen.")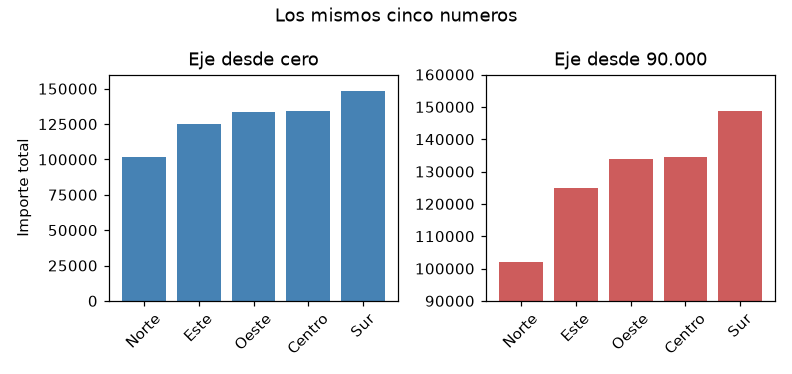
sucursal
Norte     101889.41
Este      124833.64
Oeste     133789.43
Centro    134475.27
Sur       148662.45

Relacion real entre la mayor y la menor: 1.46 veces
Relacion aparente en el grafico truncado: 4.93 veces

Las dos barras miden lo mismo. La de la derecha empieza a contar desde
90.000, asi que la longitud dejo de ser proporcional al valor.
Truncar el eje de unas barras no es un estilo: cambia lo que dicen.
Los dos gráficos usan los mismos cinco números. Sur supera a Norte por un factor de 1,46, y en el de la derecha se ve un factor de 4,93. Nadie falseó un dato: se cambió dónde empieza a contarse la longitud, y la longitud era todo el mensaje.
Acá hay que elegir
En una barra, el largo es el valor. Si la base no está en cero, el largo deja de ser proporcional y el gráfico dice algo falso. Empezar en cero es la regla, y romperla exige decirlo en el gráfico, no en una nota al pie.
En una línea, en cambio, lo que se lee es la forma del recorrido, no la distancia al piso. Forzar el cero en una serie de temperaturas corporales entre 36 y 39 grados aplasta toda la variación que importa. Ahí truncar es lo correcto.
La regla en una frase: si el gráfico codifica longitud, la base va en cero; si codifica posición, no hace falta.
Dónde se rompe
Causa: hay un valor imposible o un atípico extremo en los datos. La escala la fija el máximo.
Arreglo: mirar la fila. Si es imposible, se descarta y se informa. Si es
real y enorme, se puede usar escala logarítmica (ax.set_yscale("log"))
y decirlo bien grande, porque cambia cómo se lee todo el gráfico.
Causa: nombres de categoría largos en barras verticales.
Arreglo: ax.barh(...). Las horizontales dejan lugar para
nombres de cualquier largo y son la opción por defecto con más de siete
categorías.
Causa: barh dibuja de abajo hacia arriba, así que una serie
ordenada de mayor a menor queda con el menor arriba.
Arreglo: ax.invert_yaxis(), u ordenar ascendente antes de
dibujar.
bar_label se cortan arriba
Causa: el texto sale del área de dibujo, que se dimensionó según las barras.
Arreglo: dar aire con ax.set_ylim(0, maximo * 1.12). Es el
motivo por el que en estos ejemplos hay un set_ylim con un número
redondo.
Causa: el grano. Se agrupó por una columna que tiene filas repetidas por
otra clave, o se sumó una tabla ya unida con merge.
Arreglo: es la lección 2.2 y la 6.3. Antes de graficar, comprobá que
total.sum() coincide con la suma de la columna original.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
ax.bar(cat, valor) | Barras verticales | Pocas categorías, nombres cortos |
ax.barh(cat, valor) | Barras horizontales | Nombres largos o muchas categorías |
serie.sort_values() | Ordena por valor | Casi siempre, antes de dibujar |
ax.invert_yaxis() | Da vuelta el orden vertical | Con barh y orden descendente |
ax.bar_label(barras, padding=3) | Escribe el valor sobre cada barra | Cuando el valor exacto importa |
ax.bar_label(barras, fmt="%.0f") | Sin decimales | Importes grandes |
ax.set_ylim(0, maximo * 1.12) | Aire para las etiquetas | Junto con bar_label |
color=[...] | Un color por barra | Solo para destacar una |
ax.bar(x - 0.2, a, 0.4) y ax.bar(x + 0.2, b, 0.4) | Barras agrupadas | Dos series, no más de tres |
ax.bar(cat, b, bottom=a) | Barras apiladas | Composición de un total |
ax.set_yscale("log") | Escala logarítmica | Órdenes de magnitud reales, y se avisa |