Indice / Visualizacion con Matplotlib / 8.6
Dispersión: dos variables que varían juntas
Cada punto es una observación medida dos veces. Es el gráfico que más se usa para sacar conclusiones que no se pueden sacar.
Para qué sirve
La pregunta es «¿cuando esta sube, la otra también?». La dispersión la contesta y además muestra cosas que ningún número resume: si la relación es recta o curva, si hay grupos separados, si hay huecos y dónde están los puntos que se escapan.
Por eso conviene el orden gráfico primero, correlación después. El número solo no distingue una nube recta de una curva ni avisa que un punto lo está sosteniendo todo.
El ejemplo mínimo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

estudio = pd.DataFrame({
    "horas": [2, 3, 4, 5, 5, 6, 7, 8, 9, 10, 11, 12],
    "nota": [52, 55, 60, 62, 68, 70, 74, 78, 83, 85, 89, 92]})

r = np.corrcoef(estudio["horas"], estudio["nota"])[0, 1]

fig, ax = plt.subplots()
ax.scatter(estudio["horas"], estudio["nota"], color="purple", s=60, alpha=0.7)
ax.set_title(f"Horas de estudio y nota final (r = {r:.2f})")
ax.set_xlabel("Horas de estudio por semana")
ax.set_ylabel("Nota final sobre 100")
ax.grid(alpha=0.3)
fig.tight_layout()
plt.show()

print(estudio.to_string(index=False))
print()
print("correlacion de Pearson:", round(r, 4))
print()
print("Direccion: positiva. Intensidad: alta. Dispersion: baja, los puntos")
print("se apartan poco de una recta.")
print()
print("Lo que el grafico NO dice: que estudiar cause la nota. Podria ser que")
print("quien ya entiende la materia estudie con mas ganas, o que las dos")
print("cosas dependan de una tercera. La dispersion muestra asociacion.")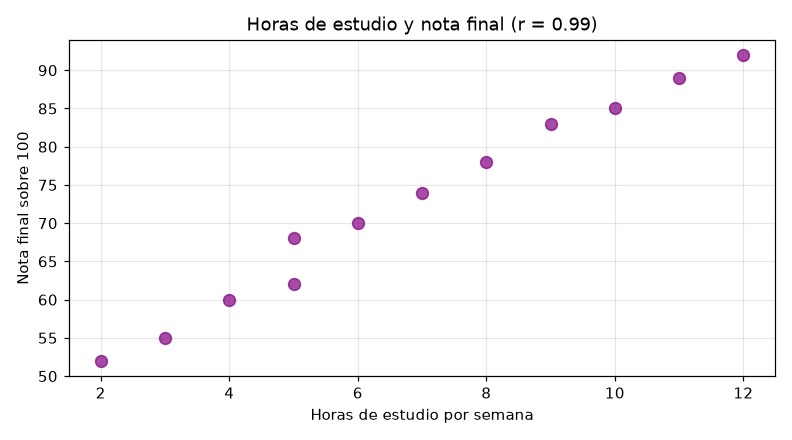
 horas  nota
     2    52
     3    55
     4    60
     5    62
     5    68
     6    70
     7    74
     8    78
     9    83
    10    85
    11    89
    12    92

correlacion de Pearson: 0.9924

Direccion: positiva. Intensidad: alta. Dispersion: baja, los puntos
se apartan poco de una recta.

Lo que el grafico NO dice: que estudiar cause la nota. Podria ser que
quien ya entiende la materia estudie con mas ganas, o que las dos
cosas dependan de una tercera. La dispersion muestra asociacion.
Tres cosas se leen de una nube, y conviene nombrarlas en ese orden: dirección (sube o baja), intensidad (qué tan pegados están a una línea) y dispersión (cuánto se apartan). La cuarta, que no se lee, es la causa.
Que las horas de estudio y la nota suban juntas es compatible con al menos tres historias: que estudiar mejore la nota, que quien ya entiende la materia estudie con más ganas, o que las dos dependan de una tercera cosa (tiempo libre, por ejemplo). El gráfico es idéntico en las tres.
La recta ajustada no cambia nada de esto. Resume la asociación, y una asociación resumida sigue siendo una asociación.
La idea: la correlación mide una sola forma de ir juntas
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

a = pd.DataFrame({"pub": [5, 7, 9, 11, 13, 15, 17, 19],
                  "ventas": [42, 48, 51, 59, 63, 68, 74, 79]})
b = pd.DataFrame({"pub": [5, 7, 9, 11, 13, 15, 17, 19],
                  "ventas": [55, 49, 64, 58, 72, 66, 81, 74]})

ra = np.corrcoef(a["pub"], a["ventas"])[0, 1]
rb = np.corrcoef(b["pub"], b["ventas"])[0, 1]

fig, ax = plt.subplots()
ax.scatter(a["pub"], a["ventas"], color="steelblue", marker="o", s=60,
           label=f"Campana A  r = {ra:.2f}")
ax.scatter(b["pub"], b["ventas"], color="darkorange", marker="^", s=60,
           label=f"Campana B  r = {rb:.2f}")
ax.set_title("A responde a la inversion de forma mas consistente")
ax.set_xlabel("Inversion publicitaria (miles)")
ax.set_ylabel("Ventas")
ax.legend()
fig.tight_layout()
plt.show()

print("A: r =", round(ra, 4))
print("B: r =", round(rb, 4))
print()
print("pendiente de A:", round(np.polyfit(a["pub"], a["ventas"], 1)[0], 2))
print("pendiente de B:", round(np.polyfit(b["pub"], b["ventas"], 1)[0], 2))
print()
print("Las dos suben, y casi con la misma pendiente. Lo que cambia es cuanto")
print("se apartan los puntos de esa recta, y eso es lo que mide r.")
print("Con la misma inversion, B da un resultado mucho menos previsible.")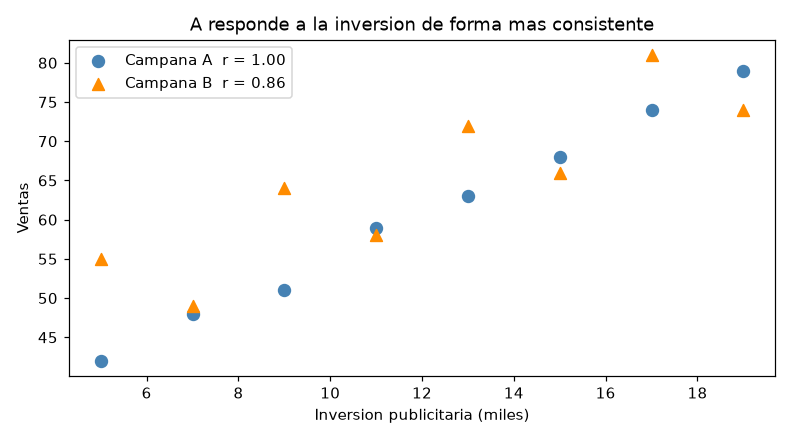
A: r = 0.9981
B: r = 0.8576

pendiente de A: 2.64
pendiente de B: 1.86

Las dos suben, y casi con la misma pendiente. Lo que cambia es cuanto
se apartan los puntos de esa recta, y eso es lo que mide r.
Con la misma inversion, B da un resultado mucho menos previsible.
Las dos campañas suben con casi la misma pendiente. Lo que las distingue es cuánto
se apartan los puntos de esa recta, y eso es exactamente lo que mide r. En
términos de negocio: con la misma inversión, la campaña B da un resultado mucho menos
previsible, y eso no aparece en el promedio de ninguna de las dos.
r no ve
np.corrcoef mide relación lineal. Una nube en forma de
U perfecta, donde la relación es total, puede dar r cerca de cero: sube y
después baja, y en promedio no hace nada. Es la razón principal para mirar el gráfico
antes que el número.
Y un detalle práctico: con un solo NaN en cualquiera de las dos
columnas, np.corrcoef devuelve nan para toda la matriz. No
saltea ausentes.
Sobre datos de verdad
Un punto que da vuelta la conclusión
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

hechos = pd.read_csv("dw_hecho_ventas.csv")

# np.corrcoef con un solo NaN devuelve nan para toda la matriz: no lo saltea.
print("r sobre la columna cruda:",
      np.corrcoef(hechos["cantidad"], hechos["ingreso"])[0, 1])

par = hechos.dropna(subset=["cantidad", "ingreso"])
x = par["cantidad"].to_numpy()
y = par["ingreso"].to_numpy()
r = np.corrcoef(x, y)[0, 1]
pendiente, intercepto = np.polyfit(x, y, 1)

fig, ax = plt.subplots()
ax.scatter(x, y, s=12, alpha=0.5)
recta = np.array([x.min(), x.max()])
ax.plot(recta, pendiente * recta + intercepto, color="crimson", linewidth=2)
ax.set_title(f"Cantidad e ingreso, sin filtrar (r = {r:.3f})")
ax.set_xlabel("Unidades vendidas")
ax.set_ylabel("Ingreso")
fig.tight_layout()
plt.show()

print("filas con los dos valores:", len(par))
print("r =", round(r, 4))
print("pendiente =", round(pendiente, 2))
print()
print("Los tres ingresos mas altos:")
print(par.nlargest(3, "ingreso")[["venta_id", "cantidad", "ingreso"]]
      .to_string(index=False))
print()
print("r casi cero y pendiente negativa: el grafico dice que vender mas")
print("unidades baja el ingreso. Lo dice una sola fila, la 480, con diez")
print("unidades y un ingreso de siete digitos.")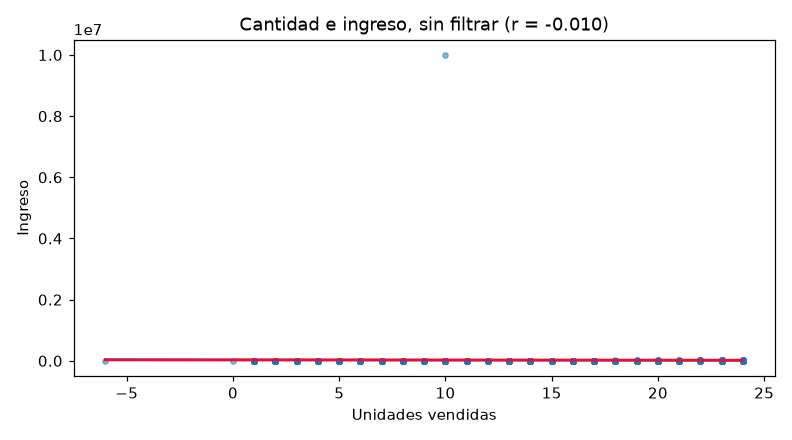
r sobre la columna cruda: nan
filas con los dos valores: 499
r = -0.0099
pendiente = -636.98

Los tres ingresos mas altos:
 venta_id  cantidad    ingreso
      480      10.0 9999999.99
      220      23.0   14091.99
      460      22.0   14043.84

r casi cero y pendiente negativa: el grafico dice que vender mas
unidades baja el ingreso. Lo dice una sola fila, la 480, con diez
unidades y un ingreso de siete digitos.
El gráfico dice que vender más unidades baja el ingreso: pendiente
−636,98 y r prácticamente cero. Lo dice una sola fila de
quinientas, la 480, con diez unidades y un ingreso de siete dígitos.
Un ajuste de mínimos cuadrados minimiza el cuadrado de las distancias, así que un punto muy lejos pesa muchísimo más que uno cercano. No es una debilidad del método: es lo que el método hace, y hay que saberlo antes de leer la recta.
Con los imposibles afuera
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

hechos = pd.read_csv("dw_hecho_ventas.csv")

# Politica: una venta tiene al menos una unidad y un ingreso entre cero y cien
# mil. Lo que queda afuera no es raro, es imposible.
valida = (hechos["cantidad"] > 0) & hechos["ingreso"].between(0, 100000)
valida = valida & hechos["cantidad"].notna()
print("descartadas:", int((~valida).sum()), "de", len(hechos))

x = hechos.loc[valida, "cantidad"].to_numpy()
y = hechos.loc[valida, "ingreso"].to_numpy()

pendiente, intercepto = np.polyfit(x, y, 1)
estimado = pendiente * x + intercepto
residual = y - estimado
r2 = 1 - np.sum(residual ** 2) / np.sum((y - y.mean()) ** 2)

fig, axes = plt.subplots(1, 2, figsize=(7.2, 3.4))

axes[0].scatter(x, y, s=12, alpha=0.4)
recta = np.array([x.min(), x.max()])
axes[0].plot(recta, pendiente * recta + intercepto, color="crimson", linewidth=2)
axes[0].set_title(f"R cuadrado = {r2:.2f}")
axes[0].set_xlabel("Unidades")
axes[0].set_ylabel("Ingreso")

axes[1].scatter(x, residual, s=12, alpha=0.4)
axes[1].axhline(0, color="black", linestyle="--")
axes[1].set_title("Residuales")
axes[1].set_xlabel("Unidades")
axes[1].set_ylabel("Observado menos estimado")

fig.tight_layout()
plt.show()

print("r =", round(np.corrcoef(x, y)[0, 1], 4))
print("recta: ingreso =", round(pendiente, 2), "* unidades +",
      round(intercepto, 2))
print("R cuadrado =", round(r2, 4))
print()
# El mismo ajuste sin filtrar nada, para tener el numero al lado y no de
# memoria. No se escribe a mano un valor que se puede calcular.
con_todo = hechos.dropna(subset=["cantidad", "ingreso"])
sucia = np.polyfit(con_todo["cantidad"], con_todo["ingreso"], 1)[0]
print("pendiente sin filtrar:", round(sucia, 2),
      " | filtrada:", round(pendiente, 2))
print("Una fila sobre quinientas daba vuelta el signo de la relacion.")
print()
print("Los residuales se abren hacia la derecha: con pocas unidades el ingreso")
print("es previsible y con muchas no. La recta describe el promedio y describe")
print("cada vez peor los casos grandes.")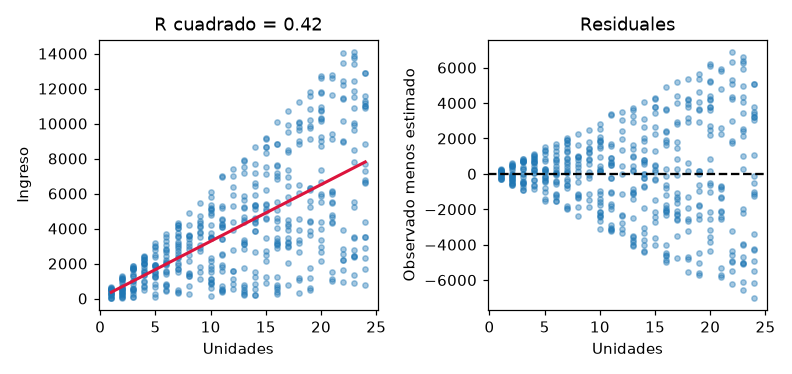
descartadas: 5 de 500
r = 0.6517
recta: ingreso = 323.69 * unidades + 37.69
R cuadrado = 0.4247

pendiente sin filtrar: -636.98  | filtrada: 323.69
Una fila sobre quinientas daba vuelta el signo de la relacion.

Los residuales se abren hacia la derecha: con pocas unidades el ingreso
es previsible y con muchas no. La recta describe el promedio y describe
cada vez peor los casos grandes.
Cinco filas de quinientas, y la pendiente pasa de −636,98 a
+323,69. La relación existía todo el tiempo: r = 0,65, y por cada
unidad vendida el ingreso sube unos 324 pesos en promedio.
El segundo eje es el que suele faltar. Los residuales se abren hacia la derecha: con pocas unidades el ingreso es previsible, con muchas no. La recta sigue describiendo bien el promedio y describe cada vez peor los casos grandes, que suelen ser los que más importan. Eso se ve en el gráfico de residuales y no se ve en el R cuadrado.
Acá hay que elegir
Cuando un punto solo cambia la conclusión, hay tres salidas y las tres son legítimas si se declaran:
- Es imposible: se descarta y se informa. Un ingreso de
9999999.99con diez unidades es eso. - Es real y raro: se conserva y se muestra el ajuste con y sin. Si las dos rectas dicen lo mismo, la conclusión es robusta; si no, la conclusión es que depende de una observación.
- Es real y pertenece a otro grupo: se separa. Una venta mayorista dentro de un archivo minorista no es un atípico, es otra población.
Lo que no es una salida es borrarlo sin decirlo.
Dónde se rompe
np.corrcoef devuelve nan
Causa: hay al menos un NaN en alguna de las dos columnas.
No los saltea: los propaga.
Arreglo: df.dropna(subset=["x", "y"]) antes, e informar
cuántas filas quedaron afuera. También sirve df[["x","y"]].corr(), que
sí los ignora, pero entonces no sabés cuántas usó.
Causa: un punto lejano. El ajuste minimiza distancias al cuadrado, así que un extremo pesa desproporcionadamente.
Arreglo: mirá los tres valores más altos y los tres más bajos antes de ajustar. Si alguno es imposible, sale.
r cerca de cero y en el gráfico se ve una relación clarísima
Causa: la relación no es lineal. Una U o una curva saturada dan
r bajo con dependencia total.
Arreglo: ninguno automático. Se describe la forma con palabras, se ajusta otra cosa, o se separa en tramos. Lo importante es no reportar «no hay relación».
Causa: sobreposición. Donde hay cien puntos encimados se ve lo mismo que donde hay uno.
Arreglo: alpha=0.3 y marcadores chicos, una muestra
aleatoria, o ax.hexbin(x, y), que cuenta por celda y es lo correcto con
decenas de miles.
Causa: una de las variables es entera y toma pocos valores. No es un defecto del gráfico: los datos son así.
Arreglo: se puede agregar un ruido mínimo para separarlos, y hay que decirlo. O usar cajas por valor de la variable entera, que suele ser más informativo.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
ax.scatter(x, y) | Un punto por observación | Dos variables continuas |
ax.scatter(x, y, s=12, alpha=0.4) | Puntos chicos y translúcidos | Cientos de puntos |
ax.scatter(..., marker="^") | Otra forma de marcador | Segundo grupo en el mismo eje |
ax.hexbin(x, y, gridsize=30) | Cuenta por celda | Decenas de miles de puntos |
np.corrcoef(x, y)[0, 1] | Correlación de Pearson | Después de mirar el gráfico |
df[["x", "y"]].corr() | Ídem, ignorando ausentes | Cómodo; no dice cuántos usó |
np.polyfit(x, y, 1) | Pendiente e intercepto | Resumir una tendencia lineal |
np.polyval(p, x) | Evalúa el ajuste | Para los residuales |
1 - sum(e**2) / sum((y - y.mean())**2) | R cuadrado | Qué parte de la variación explica |
ax.axhline(0, linestyle="--") | Referencia en cero | Gráfico de residuales |
ax.plot([xmin, xmax], p[0]*[..] + p[1]) | Dibuja la recta con dos puntos | Evita ordenar x |