Indice / Visualizacion con Matplotlib / 8.8
El panel y el guardado
Cuatro gráficos coordinados para explorar, uno solo para comunicar, y un archivo que alguien va a abrir sin vos al lado. Son tres cosas distintas y esta lección es sobre las tres.
Para qué sirve
Las cinco lecciones anteriores contestan una pregunta cada una. En un análisis real las cuatro preguntas conviven, y separarlas en cuatro imágenes sueltas obliga al lector a recordar la anterior mientras mira la siguiente. Un panel las pone juntas y deja ver lo que ninguna muestra sola: que la tendencia y la distribución cuentan la misma historia, o que no.
Después viene la otra mitad, que casi nunca se enseña: el gráfico se va a ver sin vos. Nadie va a estar ahí para explicar qué mide el eje ni por qué faltan cuatro filas. Todo eso tiene que estar adentro de la imagen.
El ejemplo mínimo
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

hechos = pd.read_csv("dw_hecho_ventas.csv")
productos = pd.read_csv("dw_dim_producto.csv")

fecha = pd.to_datetime(hechos["fecha"], format="%Y-%m-%d", errors="coerce")
valida = (hechos["cantidad"] > 0) & hechos["ingreso"].between(0, 100000)
datos = (hechos.assign(fecha=fecha)[valida & fecha.notna()]
         .merge(productos[["producto_id", "categoria"]], on="producto_id",
                how="left"))

print("filas del archivo:", len(hechos))
print("descartadas por cantidad o ingreso imposible:", int((~valida).sum()))
print("descartadas por fecha invalida:", int(fecha.isna().sum()))
print("sin categoria (producto_id que no esta en la dimension):",
      int(datos["categoria"].isna().sum()))
print("filas del panel:", len(datos))

por_mes = datos.groupby(fecha[datos.index].dt.to_period("M"))["ingreso"].sum()
por_categoria = (datos.dropna(subset=["categoria"])
                 .groupby("categoria")["ingreso"].sum().sort_values())
pendiente, intercepto = np.polyfit(datos["cantidad"], datos["ingreso"], 1)

fig, axes = plt.subplots(2, 2, figsize=(7.2, 5.6))

axes[0, 0].plot(range(len(por_mes)), por_mes.to_numpy(), marker="o")
axes[0, 0].set_xticks(range(len(por_mes)))
axes[0, 0].set_xticklabels([str(p)[-2:] for p in por_mes.index])
axes[0, 0].set(title="Tendencia mensual", xlabel="Mes de 2026",
               ylabel="Ingreso")

axes[0, 1].barh(por_categoria.index, por_categoria.to_numpy())
axes[0, 1].set(title="Ingreso por categoria", xlabel="Ingreso")

axes[1, 0].hist(datos["ingreso"], bins=14, edgecolor="white")
axes[1, 0].axvline(datos["ingreso"].mean(), color="crimson", linestyle="--",
                   label="Media")
axes[1, 0].set(title="Distribucion del ingreso", xlabel="Ingreso",
               ylabel="Ventas")
axes[1, 0].legend()

axes[1, 1].scatter(datos["cantidad"], datos["ingreso"], s=10, alpha=0.35)
extremos = np.array([datos["cantidad"].min(), datos["cantidad"].max()])
axes[1, 1].plot(extremos, pendiente * extremos + intercepto, color="crimson")
axes[1, 1].set(title="Unidades contra ingreso", xlabel="Unidades",
               ylabel="Ingreso")

fig.suptitle("Ventas 2026: cuatro preguntas sobre la misma tabla")
fig.tight_layout()
plt.show()

print()
print("ingreso por mes:")
print(por_mes.round(0).to_string())
print()
print("ingreso por categoria:")
print(por_categoria.round(0).to_string())
print()
print("media del ingreso:", round(datos["ingreso"].mean(), 2),
      " mediana:", round(datos["ingreso"].median(), 2))
print("recta: ingreso =", round(pendiente, 2), "* unidades +",
      round(intercepto, 2))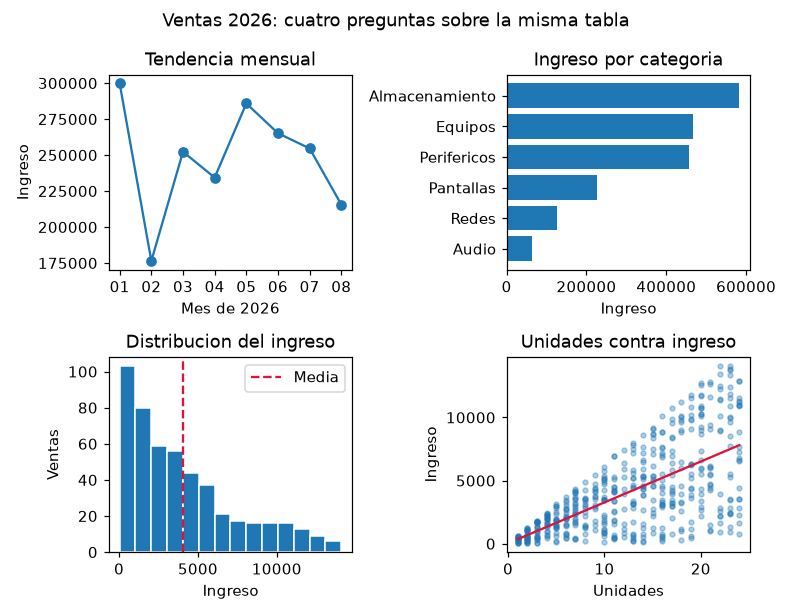
filas del archivo: 500
descartadas por cantidad o ingreso imposible: 5
descartadas por fecha invalida: 2
sin categoria (producto_id que no esta en la dimension): 24
filas del panel: 493

ingreso por mes:
fecha
2026-01    299773.0
2026-02    176428.0
2026-03    252314.0
2026-04    234356.0
2026-05    285869.0
2026-06    265187.0
2026-07    254614.0
2026-08    215609.0
Freq: M

ingreso por categoria:
categoria
Audio              64554.0
Redes             125860.0
Pantallas         225767.0
Perifericos       457954.0
Equipos           465728.0
Almacenamiento    581644.0

media del ingreso: 4045.99  mediana: 3144.63
recta: ingreso = 323.71 * unidades + 36.12
Las cuatro preguntas del curso sobre la misma tabla: tendencia, comparación,
distribución y relación. Cada eje conserva su escala y su lectura, y por eso el
suptitle dice de qué es el panel mientras cada set_title dice
qué contesta ese eje.
Cinco filas con cantidad o ingreso imposible, dos con fecha inválida y
veintisiete que apuntan a un producto_id que no está en la tabla de
productos. Esas veintisiete tienen categoría vacía: entran en tres de los
cuatro gráficos y no en el de categorías, así que ese eje suma menos que los otros.
Es un caso de la lección 6.3, y en un panel se vuelve visible: si alguien suma las barras de la derecha y las compara con la línea de la izquierda, no le va a dar. Hay que decirlo antes de que pregunte.
Sobre datos de verdad
De cuatro preguntas a una lámina
import pandas as pd
import matplotlib.pyplot as plt

hechos = pd.read_csv("dw_hecho_ventas.csv")
productos = pd.read_csv("dw_dim_producto.csv")

valida = (hechos["cantidad"] > 0) & hechos["ingreso"].between(0, 100000)
datos = (hechos[valida]
         .merge(productos[["producto_id", "categoria"]], on="producto_id",
                how="left")
         .dropna(subset=["categoria"]))

por_categoria = datos.groupby("categoria")["ingreso"].sum().sort_values()
parte = por_categoria.max() / por_categoria.sum() * 100
lider = por_categoria.idxmax()

# El panel es para explorar. La lamina que va al informe muestra UNA cosa, y
# el titulo dice cual: el lector no tiene que descubrirla.
colores = ["darkorange" if c == lider else "0.6" for c in por_categoria.index]

fig, ax = plt.subplots(figsize=(7.2, 3.6))
barras = ax.barh(por_categoria.index, por_categoria.to_numpy(), color=colores)
ax.bar_label(barras, fmt="%.0f", padding=4, fontsize=8)
ax.set_title(f"{lider} explica el {parte:.0f} % del ingreso de 2026")
ax.set_xlabel("Ingreso acumulado, enero a agosto")
ax.set_xlim(0, por_categoria.max() * 1.25)
ax.spines["top"].set_visible(False)
ax.spines["right"].set_visible(False)
fig.tight_layout()

# savefig escribe el archivo; show lo muestra. En un script que corre solo no
# hay pantalla, asi que savefig es lo unico que deja algo. Van en este orden:
# show() puede vaciar la figura en algunos backends.
fig.savefig("ingreso_por_categoria.png", dpi=150)
plt.show()

print(por_categoria.round(2).to_string())
print()
print("total:", round(por_categoria.sum(), 2))
print(f"{lider}: {parte:.1f} % del total")
chicas = por_categoria.drop(lider).head(3)
print("las tres mas chicas juntas:", round(chicas.sum(), 2),
      "->", list(chicas.index))
print("siguen sin alcanzar a", lider, "solo:", round(por_categoria.max(), 2))
print()
print("Un panel de cuatro contesta cuatro preguntas y no dice ninguna.")
print("La lamina dice una y la deja escrita en el titulo.")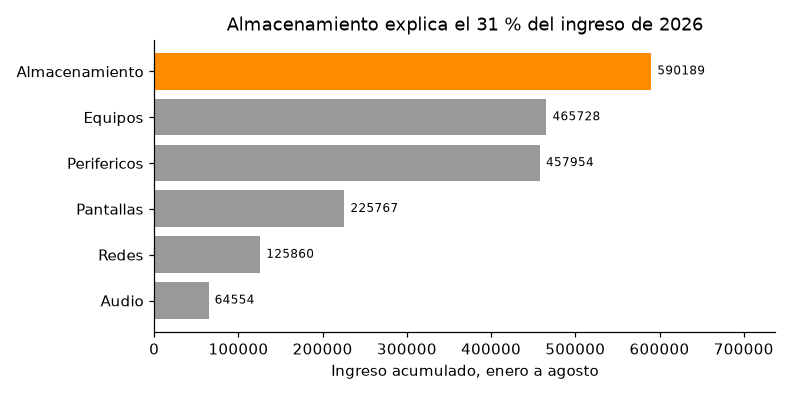
categoria
Audio              64554.15
Redes             125860.30
Pantallas         225766.76
Perifericos       457953.53
Equipos           465727.72
Almacenamiento    590189.00

total: 1930051.46
Almacenamiento: 30.6 % del total
las tres mas chicas juntas: 416181.21 -> ['Audio', 'Redes', 'Pantallas']
siguen sin alcanzar a Almacenamiento solo: 590189.0

Un panel de cuatro contesta cuatro preguntas y no dice ninguna.
La lamina dice una y la deja escrita en el titulo.
El panel explora; la lámina afirma. Un panel de cuatro contesta cuatro preguntas y no dice ninguna: sirve para entender, no para convencer. Cuando el análisis terminó y hay algo que decir, se dice en un gráfico con una idea, un color de acento sobre el hallazgo y un título que ya lo enuncia.
Comparalo con el panel: los mismos datos, y acá el lector se lleva una frase. Almacenamiento explica el 30,6 % del ingreso, y las tres categorías más chicas juntas (416.181) no le llegan.
Cuando los puntos se tapan
import pandas as pd
import matplotlib.pyplot as plt

hechos = pd.read_csv("dw_hecho_ventas.csv")
valida = (hechos["cantidad"] > 0) & hechos["ingreso"].between(0, 100000)
datos = hechos[valida]
x, y = datos["cantidad"], datos["ingreso"]

fig, axes = plt.subplots(1, 3, figsize=(7.2, 3.0), sharey=True)

axes[0].scatter(x, y, s=30)
axes[0].set_title("Opaco")
axes[0].set_ylabel("Ingreso")

axes[1].scatter(x, y, s=30, alpha=0.15)
axes[1].set_title("alpha = 0.15")

axes[2].hexbin(x, y, gridsize=18, cmap="Blues")
axes[2].set_title("hexbin")

for eje in axes:
    eje.set_xlabel("Unidades")
fig.suptitle("Los mismos 495 puntos")
fig.tight_layout()
plt.show()

print("puntos dibujados:", len(datos))
print()
# Lo que el ojo no puede contar en el primer grafico: cuantas ventas hay en
# cada tramo de unidades. La tabla lo dice sin ambiguedad.
tramos = pd.cut(x, bins=[0, 5, 10, 15, 20, 25])
resumen = datos.groupby(tramos, observed=True)["ingreso"].agg(
    ["count", "mean", "median"]).round(2)
resumen.index.name = "unidades"
print(resumen.to_string())
print()
print("La transparencia deja ver donde hay mas puntos y sigue siendo una")
print("impresion. hexbin lo cuenta, y con decenas de miles de puntos es la")
print("unica de las tres que sigue funcionando.")
print("La tabla de arriba es la que se puede citar en el informe.")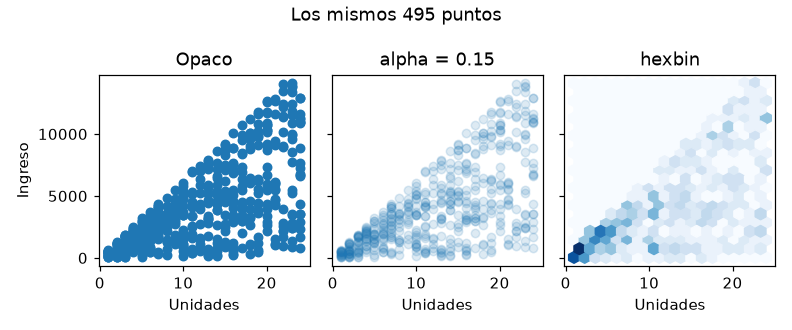
puntos dibujados: 495

          count     mean   median
unidades
(0, 5]      107  1090.67   995.83
(5, 10]     103  2718.32  2762.43
(10, 15]    101  4043.67  4338.52
(15, 20]    107  5970.69  5559.28
(20, 25]     77  7263.07  6756.51

La transparencia deja ver donde hay mas puntos y sigue siendo una
impresion. hexbin lo cuenta, y con decenas de miles de puntos es la
unica de las tres que sigue funcionando.
La tabla de arriba es la que se puede citar en el informe.
Cuatrocientos noventa y cinco puntos ya alcanzan para que la nube opaca sea una
mancha. La transparencia deja ver dónde hay más y sigue siendo una impresión;
hexbin cuenta por celda, y con decenas de miles de puntos es la única de las
tres que sigue funcionando. La tabla por tramos es la que se puede citar.
Acá hay que elegir
show() o savefig()
plt.show() abre una ventana y sirve mientras explorás.
fig.savefig("archivo.png") escribe un archivo y es lo único que deja algo
cuando el script corre sin pantalla, que es como corre en un servidor o en una tarea
programada.
Van en ese orden: savefig antes de show.
En algunos backends la ventana consume la figura y lo que se guarda después sale en
blanco.
Sobre el dpi: 100 alcanza para una pantalla, 150 para un informe
impreso, 300 para una publicación. Más resolución no agranda las letras, así que un
gráfico a 300 dpi con fontsize por defecto tiene el texto proporcionalmente
más chico. Si hay que agrandar el texto, se agranda el texto.
Dónde se rompe
Causa: se llamó a savefig después de show().
Arreglo: guardar primero. Y en un script sin pantalla,
matplotlib.use("Agg") antes de importar pyplot.
Causa: falta fig.tight_layout(), o se llamó antes de poner los
rótulos.
Arreglo: última línea antes de guardar. Si aun así queda apretado, el panel necesita más alto, no menos texto.
Causa: están al lado y parecen comparables. Si miden cosas distintas, no lo son.
Arreglo: títulos y unidades explícitos en cada eje. Y si sí son
comparables, sharey=True, que lo hace evidente.
Causa: se subió el dpi creyendo que agranda todo. Agranda los
píxeles, no los puntos tipográficos.
Arreglo: más figsize, o fontsize explícito en los
rótulos. El dpi solo decide cuántos píxeles tiene cada pulgada.
Causa: el gráfico se hizo con una versión de los datos y la tabla con otra, o con distinto criterio de descarte.
Arreglo: que el gráfico y la tabla salgan del mismo DataFrame en el mismo script. Es la razón por la que todos los ejemplos de esta unidad imprimen los números que dibujan.
Recetario
| Expresión | Qué hace | Cuándo |
|---|---|---|
plt.subplots(2, 2, figsize=(7.2, 5.6)) | Panel; axes[fila, col] | Cuatro preguntas juntas |
ax.set(title=..., xlabel=..., ylabel=...) | Los tres rótulos de una vez | Paneles, para no repetir |
fig.suptitle(...) | Título de la figura entera | Dice de qué es el panel |
fig.tight_layout() | Acomoda los márgenes | Último, antes de guardar |
fig.savefig("a.png", dpi=150) | Escribe el archivo | Antes de show() |
matplotlib.use("Agg") | Backend sin pantalla | Scripts en servidor; antes de importar pyplot |
ax.spines["top"].set_visible(False) | Saca el marco de arriba | Láminas de informe |
ax.hexbin(x, y, gridsize=18) | Cuenta por celda | Nubes densas |
pd.cut(v, bins=[...]) | Tramos para la tabla | El respaldo citable del gráfico |
plt.close(fig) | Libera la figura | Al generar muchas en un bucle |
Los seis errores que cierran la unidad
| Error | Qué produce | Corrección | Dónde se vio |
|---|---|---|---|
| Eje truncado | Exagera diferencias en barras | Base en cero, salvo justificación explícita | 8.4 |
| Color sin función | Compite con la estructura | Paleta corta; el acento para el hallazgo | 8.2, 8.4 |
| Título genérico | Obliga a descubrir el mensaje | El título enuncia la conclusión | 8.4, 8.8 |
| Intervalos arbitrarios | La forma depende de la elección | Probar varias, elegir cortes con sentido, declararlo | 8.5 |
| Sobreposición | Miles de puntos ocultan la densidad | Transparencia, muestreo o hexbin | 8.8 |
| Correlación leída como causa | Conclusiones que el dato no sostiene | Una recta resume asociación, no causalidad | 8.6 |
Y el que no está en esa lista porque atraviesa toda la unidad: un dato imposible deforma el gráfico mucho más de lo que deforma la tabla. Una fila sobre quinientas dio vuelta el signo de una regresión, una lectura sobre doscientas cuarenta apagó un detector de anomalías, y una transacción sobre doscientas hizo desaparecer cuatro sucursales. En los tres casos el código corría limpio.